全新的AIOps平台連接基礎設施和工作負載遙測數據,幫助營運商提高正常運作時間和最大限度地提高AI工廠的產量
NVIDIA Minerva 於今日正式發布,這是一個旨在幫助團隊更早發現問題並保持 AI 工廠高效運作的 AIOps 平台。它整合了來自基礎設施和 AI 工作負載的遙測數據,然後應用專門建立的 AI 模型,將這些數據轉化為及時、可執行的洞察。
人工智慧工廠是世界上最複雜的營運之一,其中大量的 GPU 透過高速網路協同工作,用於訓練模型和運行人工智慧應用。在如此龐大的規模下,單一元件的效能下降就可能導致整個作業運作緩慢。一些預警訊號可能很容易被忽視,例如 GPU 運行溫度高於其他組件,或 NVMe 固態硬碟在高負載下效能下降。
該平台專注於 AI 工廠的產出,這是衡量基礎設施透過 GPU 小時數、吞吐量、叢集正常運作時間和詞元產量產生的有效工作量的指標。
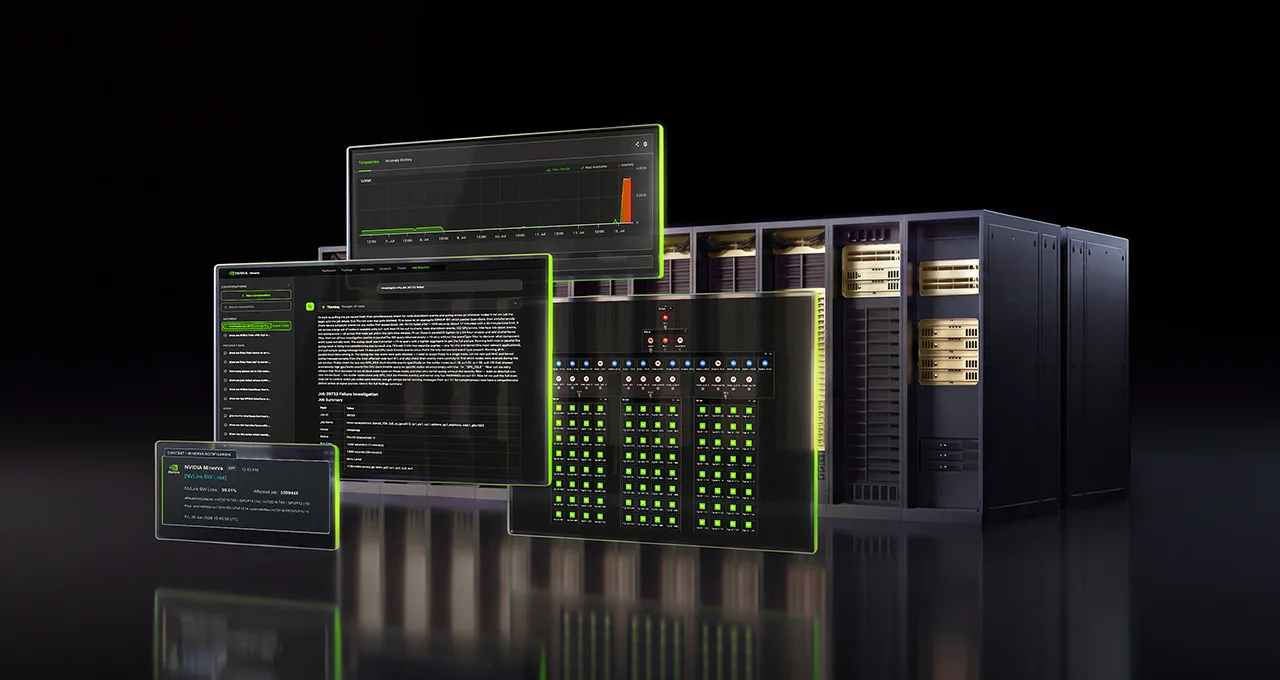
呈現人工智慧工廠的動態視圖
傳統的監控工具通常將資料中心劃分為不同的視圖。網路、運算、站點可靠性和機器學習團隊各自負責不同的運作部分。 Minerva 則將 NVIDIA GPU、網路、儲存、調度器和工作負載等各個環節的訊號連接起來。
利用這些訊號,Minerva 建立了一個動態知識圖譜,該圖譜能夠邏輯地映射基礎架構(包括 GPU、SuperNIC、交換器和線纜)及其上執行的作業。這種上下文資訊有助於維運人員追蹤運作緩慢的訓練作業,即使在擁有數十萬個 GPU 的大型工廠中,也能找到影響該作業的元件。
它利用監督式和非監督式機器學習,每小時分析數十億個數據點。它能夠學習正常行為,檢測以前未曾發現的異常情況,預測即將出現的故障,並根據工廠的拓撲結構關聯相關事件。它不會將所有症狀都發送給操作員,而是將一系列事件歸類為具有可能根本原因的重點事件。
Minerva 內建原生 AI 助手,並可連接外部智慧 AI 工具。這為其提供了一個基於即時遙測數據的自然語言介面。維運人員可以透過對話了解集群健康狀況並取得修復建議。團隊可以安排專人參與,手動實施修復,也可以透過基礎設施應用程式介面 (API) 和外部系統將 Minerva 連接到自動化流程。
最大化人工智慧工廠產量的結果
Minerva 能夠關聯工作負載和基礎設施問題,並結合其智慧 AI 功能,從而簡化 AI 工廠的運作。它不會像以往那樣處理大量警報,而是將相關問題聚合為一個可執行的單一任務。這使得 AIOps 團隊能夠從被動維護轉變為主動維護。而這一切都有助於 AI 工廠最大限度地延長 GPU 正常運作時間。
Minerva 為人工智慧工廠關注的關鍵指標提供價值:
- 中斷間隔時間更長:Minerva 能在問題發生之前發現它,因此作業可以更長時間無故障運行。
- 更快的修復時間:當發生事故時,Minerva 可以精確定位問題,從而顯著加快解決問題的速度。
- 更深入的洞察:現代人工智慧基礎設施會產生大量資料;Minerva 對其進行過濾,只留下真正重要的少數警報。
IREN 是 NVIDIA 的合作夥伴之一,它使用 Minerva 來優化其 AI 工廠。
「隨著我們人工智慧工廠規模的擴大,為客戶提供最佳服務的關鍵在於最大限度地提高 GPU 的生產力,」IREN 首席技術長 Denis Skrinnikoff 表示。“NVIDIA Minerva 為我們的運維團隊提供了一個統一的網路視圖,涵蓋 GPU 及其上運行的作業,因此我們可以將更多精力集中在主動維護而非故障排除上。這種可視性增強了我們正在構建的下一代基礎設施的運營模式。”
繼 IREN 之後,Aolani 、Bitdeer AI、IBM 、Jio、 Lambda 、Quake AI 和 Tesla 也計劃部署 Minerva。
除了 戴爾科技集團之外,聯想和超微也將把 Minerva 作為其人工智慧工廠營運產品組合的一部分提供。
了解更多關於 NVIDIA Minerva 的資訊。
現在就加入 ioioTIMES 臉書粉絲團 更多互動、更多好康攏抵加!!
我們有LINE TODAY頻道了,快來追踪我們吧!!--最新科技新聞 盡在你手