從編碼代理到個人助理和物理系統,代理工作負載正在對整個計算範式提出新的要求
在您下次開會之前,您的個人人工智慧助理會識別即將舉行的會議,並主動開始準備,無需等待您的提示。它會查看您的行事曆,整理相關的郵件和文檔,識別您的會議對象,並在您參加會議前提供您可能需要的資訊。
在這經驗的背後,智能體可以將設備上儲存的上下文資訊與企業應用程式、雲端服務和專業模型結合。然後,它會判斷哪些資訊至關重要、應該使用哪些工具、任務的各個部分應該在何處運行,以及每個結果如何影響後續操作。正是這一點,使得智能體人工智慧超越了以模型為中心的傳統工作負載。
模型可以提供推理過程,但完成任務取決於更廣泛的系統,該系統需要協調記憶體、軟體、工具以及跨多個步驟的不同類型計算資源。保持從第一條指令到最終結果的整個流程暢通無阻,正成為智能體人工智慧領域最具決定性的工程挑戰之一。
智能體人工智慧從結果出發
Arm 人工智慧解決方案架構總監 Laurence Moroney 將基本的智能體循環分為四個階段:理解意圖、計劃、行動和反思。在這裡,意圖改變了起點。智能體不再需要遵循預先定義的應用程式流程,而是可以從期望的結果出發,並確定下一步需要哪些資訊、模型、工具或軟體。
AutoCore 的執行長兼聯合創始人楊章博士 (Yang Zhang) 認為,這將從根本上改變人們與軟體的互動方式。傳統上,應用程式需要使用者將自己的需求轉化為機器可以理解的介面,例如選擇正確的應用程式、瀏覽選單或以規定的格式輸入資訊。楊章博士認為,隨著智慧體人工智慧的出現,這種互動將變得更加以人為本,並日益呈現多模態特性,系統會從一個更簡單的問題開始:你想做什麼?
這意味著並非所有指令都會立即完成,因為代理仍然需要將意圖轉化為一系列操作。例如,編碼代理程式可能會檢查程式碼庫、進行修改、執行測試,並根據結果進行調整。另一方面,客戶服務助理可以在決定如何解決請求之前,從帳戶記錄、政策和外部服務中提取資訊。在工業環境中,代理程式可能會在決定呼叫哪個軟體工具或執行哪個物理操作之前,先解讀感測器資料。
隨著任務步驟的增多,上下文和記憶體也成為工作負載的一部分。先前的指令、檢索到的資訊和中間結果都可能在後續步驟中再次發揮作用。具體到設備端,不斷增長的上下文資訊必須能夠容納在有限的記憶體空間內,而這部分記憶體空間已經與作業系統、應用程式和其他人工智慧工作負載共享。
Meta 的工程經理 Cemal Bilgin 透過他參與 ExecuTorch(Meta 的開源設備端機器學習運作時)的工作,深刻體會到了這些限制。 Meta 的一系列應用已經運行了數百個模型,而代理工作負載則提出了更高的要求:系統必須保留足夠的上下文資訊才能繼續執行任務,同時避免丟失已處理的資訊。將更多上下文資訊保存在記憶體中會消耗記憶體容量,而壓縮或再次檢索這些資訊則可能在保真度、延遲和效率之間產生權衡。
然而,有些背景資訊很難掌握。組織內部人員通常知道某個流程存在的意義,之前的決策是如何做出的,或是之前遇到類似問題時是如何處理的。正如比爾金所說:“對於代理人來說,我可能需要逐條解釋清楚我們究竟在尋找什麼。”
更自然、以人為本的介面能讓使用者更容易表達意圖,但有效的智能體仍需要足夠的上下文資訊才能正確解讀意圖。因此,文件、政策和領域專業知識都成為智能體在達成目標過程中可能需要的資訊。
在個人裝置上,這一點尤其重要,因為對代理商的輸入不僅限於明確的請求,還包括裝置能夠感知、記住和理解的有關使用者的資訊。
智能體人工智慧依賴高效的協調
vivo 首席晶片組規劃專家 Eric Xia 進一步闡述了這個概念。他描述了這樣一種個人智能體:「它需要時刻感知用戶周圍發生的一切,保留相關信息,預測用戶的需求,並在各種應用和設備上完成任務。」在智能手機上,這些功能必須與固定電池、共享內存、活躍的傳感器以及全天都在爭奪計算資源的應用程序共存。
要支援這些功能,僅僅增加一個模型或使用更大的模型是不夠的。 Xia 解釋說,作業系統不能再僅僅充當硬體的管理者,它必須管理上下文和使用者意圖,以及自主操作所需的安全控制。硬體也需要發展,以便在設備上有效地支援專用模型,尤其是在嚴格的功耗和散熱限制下。這意味著,智能體人工智慧需要從根本上重新設計整個系統——包括軟體和硬體。
▲一段動畫視頻,展示了基礎計算平台對於下一代 AI 工作負載的重要性,以及 Arm 如何使智慧能夠在日益分佈式的世界中運行
物理人工智慧將這項挑戰擴展到軟體決策可能對現實世界產生影響的系統。例如,一個人形機器人可能正在處理攝影機畫面、解讀感測器資料並控制運動,同時智慧體要求更多資訊或決定下一步。
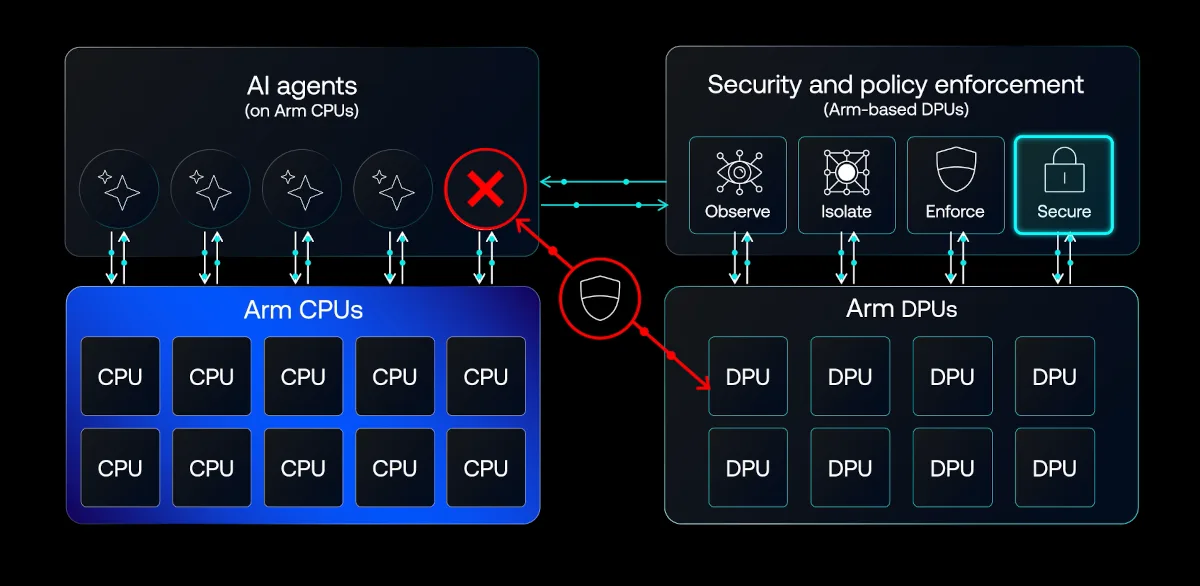
Yang Zhang 認為代理程式運行時是幫助管理這種複雜性的重要層。它可以調度任務、控制資源存取、管理權限並協調本地和雲端環境中的執行。
在物理系統中,這些控制有助於界定自主性的界線。工程師需要了解智能體被允許做什麼、它正在使用哪些資源以及它的行為如何與機器的其他部分互動。隨著智能體越來越接近現實世界的決策過程,這些邊界對於確保智能體行為在大規模應用中的可靠性至關重要。
擴大智能體人工智慧的規模會為基礎設施帶來壓力
Google 讓我們得以提前了解智能體工作流程在軟體規模下運作時會發生什麼。他們的單體倉庫包含數十億行程式碼,大規模遷移可能需要在建置、測試和應用程式之間進行協調變更。
Google 開發者關係工程師 Wolff Dobson 曾參與過旨在處理部分遷移流程的多智能體系統項目,他將這種架構比作「幾位智能體穿在一件風衣裡」。其中,協調智能體可以將遷移過程分解成更小的任務,而其他智能體則可以調查建置失敗的原因、修改程式碼或執行測試。
代理可以快速產生變更,但圍繞它們的工程系統仍然需要跟上步伐。 Dobson 指出,Piper 是 Google 在傳統系統難以應對其單體倉庫規模後所建構的客製化原始碼控制系統。代理工作流程進一步加劇了這種壓力,因為每次變更都可能需要儲存、建置、測試和評估,然後才能開始下一個操作。
智能體人工智慧還可以加速工程開發工作本身。 Bilgin 指出,在 Meta 公司部署設備端人工智慧的生命週期中,模型和運行時開發、測試、效能和準確性優化、A/B 測試以及逐步推廣可能需要數月甚至更長時間。智能體工作流程可以透過協助進行模型基準測試、識別崩潰或準確性問題,並更快地推進到下一個部署階段,從而縮短部分流程。
這種加速使得底層工程學科的重要性不減反增。莫羅尼區分了執行單一代理程式和同時執行多個代理程式:單一代理呼叫 API 很簡單;而上千個代理程式同時呼叫 API 則會產生常見的系統級問題。同樣的原則仍然適用——設計時要考慮規模,識別瓶頸,考慮資源限制,並明確定義代理的權限邊界。
智能體人工智慧可以提高工作速度和工作量,但要可靠地擴展其規模,仍取決於能否正確掌握這些基本要素。
績效將以結果來衡量
智能體人工智慧也改變了性能的衡量標準。模型延遲和吞吐量仍然是有用的衡量指標,但它們僅反映了任務的一部分,任務可能涉及資訊檢索、工具呼叫、等待服務或步驟之間的上下文轉換。
對於使用智慧代理的使用者而言,真正有意義的衡量標準是結果:任務是否完成、耗時多久,以及系統完成任務的可靠性和效率如何?實現端到端的效能取決於系統協調模型周圍工作的效率。通用的運算和軟體平台能夠為開發人員提供一致的基礎,從而降低跨雲端、邊緣和實體系統建置和最佳化的複雜性,因為工作負載可以在這些系統之間遷移。
但這只是等式的一部分。智能體系統將整合來自整個產業的模型、執行時間工具、硬體和服務,因此開放介面和協作對於這些資源的高效協同至關重要。正如夏所言,“開放性需要從一開始就融入設計之中,整個生態系統需要協同運作,而不是構建孤立的堆疊。”
高效的系統設計、通用的運算平台以及開放的多廠商生態系統相結合,是智慧體人工智慧得以規模化發展的關鍵。因此,人工智慧的下一階段發展不僅取決於單一模型的能力提升,更取決於整個系統如何有效地將智慧轉化為有用的行動。
現在就加入 ioioTIMES 臉書粉絲團 更多互動、更多好康攏抵加!!
我們有LINE TODAY頻道了,快來追踪我們吧!!--最新科技新聞 盡在你手