AgentX:在真實世界、長期代理工作負載下達到469 tok/s
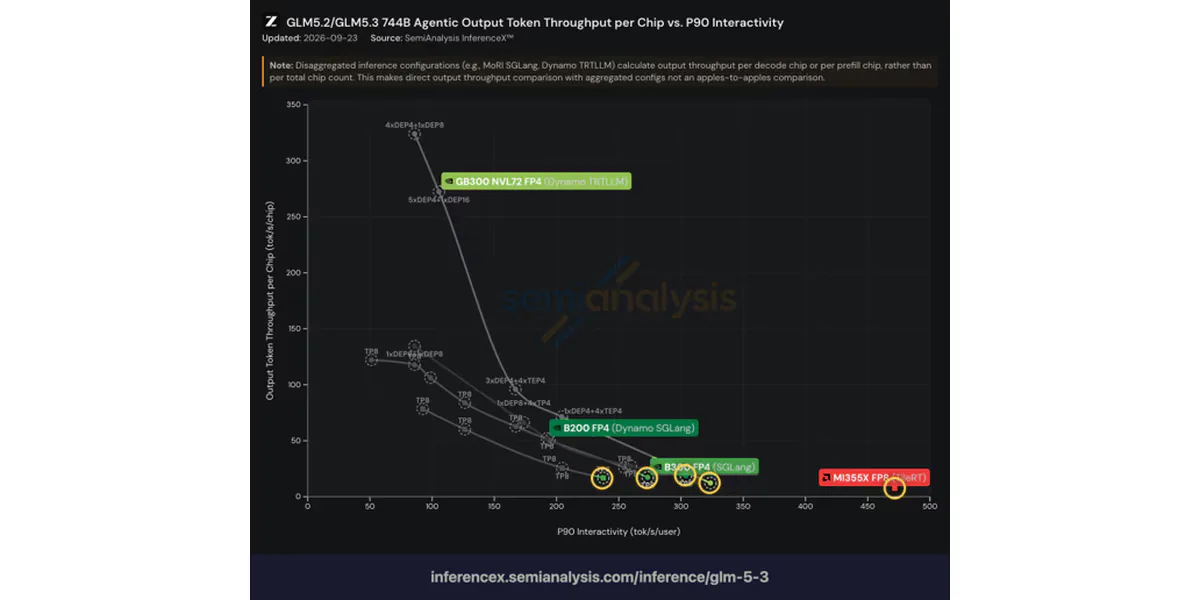
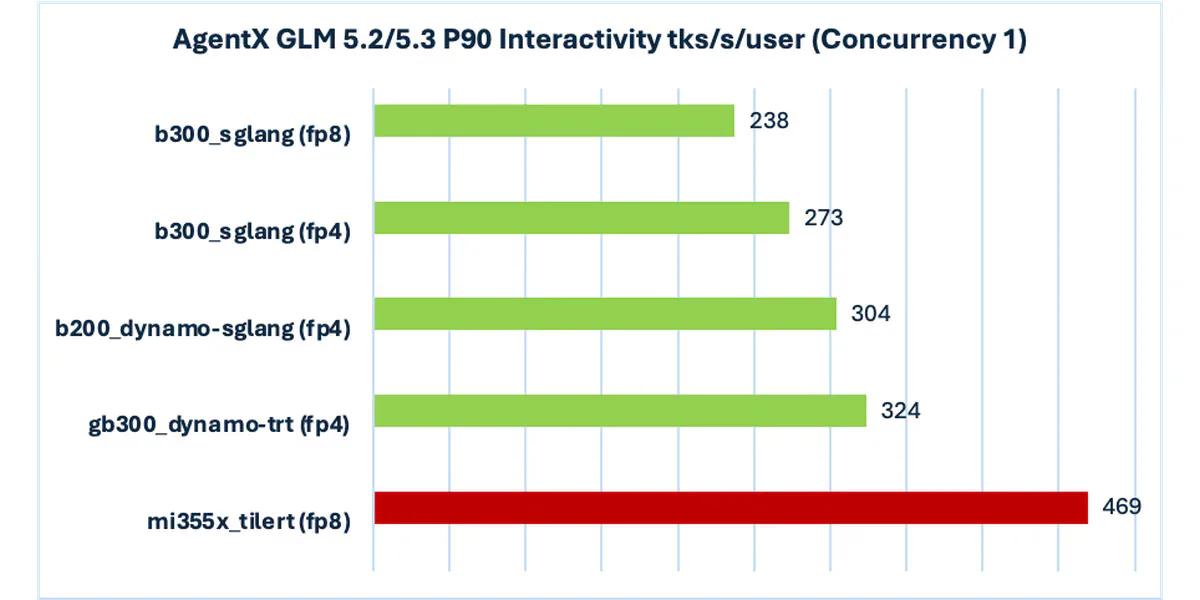
在最新的 InferenceX AgentX 排名中,TileRT 為 GLM-5.3 提供了動力,在 8 個 AMD Instinct™ MI355X GPU 上實現了 469 tok/s 的單用戶生成吞吐量,在 AgentX 排行榜上名列榜首,領先第二名 NVIDIA GB300 NVLk/ 系統以上。
AgentX測量哪些指標?
InferenceX(原名 InferenceMAX),由 SemiAnalysis 主導開發,是開放的、廠商中立的、可重複的推理基準測試平台。 AgentX 則專注於在反映編碼代理程式實際運作方式的工作負載下測試推理效能。
這與傳統的固定提示長度的基準測試非常不同。
AgentX 工作負載源自於真實的編碼代理軌跡。為了使基準測試可復現,原始內容被移除,並使用確定性的合成標記進行重建,同時保留原始會話的結構:多輪交互、不斷增長的共享前綴、工具調用暫停以及主代理與其子代理之間的依賴關係。
換句話說,AgentX 衡量的是整個代理會話期間的效能。隨著任務的進行和情境的不斷擴展,維持高生成速度的能力變得越來越重要。
469 tok/s:在AgentX單用戶效能方面排名第一
在 AgentX 工作負載下,運行 GLM-5.3 的 TileRT 在 8 個 AMD Instinct MI355X GPU上實現了: 469 tok/s 的單一用戶生成吞吐量。
對於長週期代理任務,TileRT 選擇不犧牲數值精確度來換取速度。憑藉原始的 FP8 權重精度和 BF16 KV 緩存,TileRT 仍然在 AgentX 排行榜上取得了最快的單用戶成績,比排名第二的 NVIDIA GB300 NVL72(運行 FP4)快了 100 tok/s 以上。
從1K到1M情境:長度增加1000倍,速度保留約2/3
除了 AgentX 最終的 469 tok/s 的結果之外,我們還有另一個非常關心的指標:隨著上下文的成長,效能能維持多少?
AgentX 會話可以成長到數百萬個詞元。隨著上下文長度的增加,產生每個新詞元都需要存取越來越大的鍵值緩存,這使得解碼過程中的記憶體存取成本越來越高。因此,在短上下文下表現出的強大效能並不一定能轉化為長時間運行的代理會話中同樣出色的互動性。
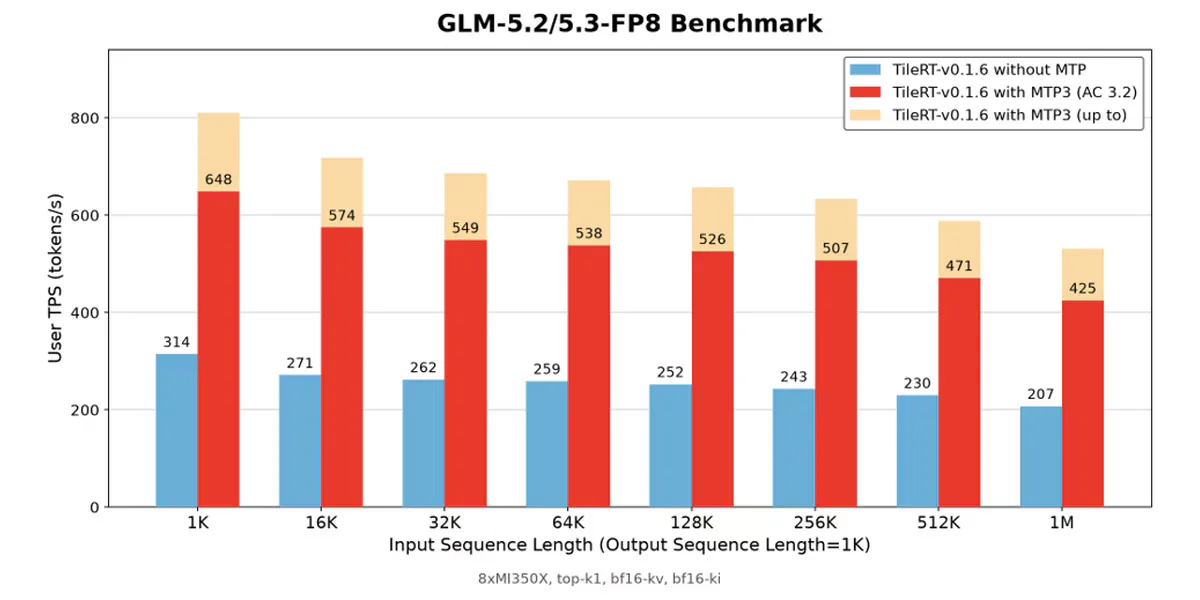
如圖 2 所示,當輸入情境從 1K 個 token 成長到 1M 個 token(成長了 1000 倍)時, 單一使用者產生速度從 648 tok/s 下降到 425 tok/s。即使在 100 萬個 token 的上下文中,TileRT 仍然保持了其短上下文表現的大約三分之二。
這對代理程式的工作負載至關重要。真實的代理會話會不斷累積上下文訊息,隨著任務運行時間的延長,長上下文解碼效能越來越決定使用者體驗到的互動效果。
圖 2 的數據來自我們對 8 塊 MI350X GPU 的開發測試,而 AgentX 排行榜的結果則是在 8 塊 MI355X GPU 上測得的。 MI350X 和 MI355X GPU 都基於 CDNA 4 架構,但 MI350X GPU 的運作頻率較低。因此,與 AgentX 使用的 MI355X 配置相比,圖 2 中的結果提供了一個相對保守的參考。
測試配置: AgentX 排行榜結果使用 8 個 MI355X GPU,而圖 2 中的長上下文解碼測量使用 8 個 MI350X GPU。兩種配置均使用 TP8、公開的 GLM-5.3 權重、FP8 以及 MTP K=3 的推測性解碼。完整的排行榜配置請參閱我們提交的 InferenceX 文件。
TileRT是如何實現的
TileRT 從一開始就被設計成低延遲的。
當人們談論規模定律時,通常會提到模型參數和訓練資料。但對於智能體而言,我們認為還有另一個重要的維度:速度。更快的推理速度意味著智能體可以在相同時間內完成更多輪的推理、工具使用和環境互動。從這個意義上講,速度本身就是規模智慧的一個維度。
在延遲優先的工作負載中,隨著硬體運算和記憶體頻寬的不斷提升,解碼前向傳遞過程中實際用於計算的時間變得越來越短。其他開銷——例如核心啟動、跨核心同步以及與全域記憶體的往返——開始進入關鍵路徑。
在以吞吐量為導向的工作負載中,這些成本通常隱藏在計算背後。但在極低延遲的情況下,它們會變得越來越明顯。我們稱之為執行差距。
TileRT 的核心方法是在編譯時將整個模型靜態展開到 GPU 上的持久引擎核心。計算、通訊和非同步 I/O 都在該引擎內持續進行。不存在逐個核心啟動的順序,最佳化也不再受限於核心邊界:最佳化範圍從單一核心擴展到整個前向傳播過程。
在 MI355X GPU 上,我們專注於三個方面,以進一步縮小執行差距。
1. 從全球障礙到串流同步
一旦執行轉移到持久性內核,內核邊界就會消失,它們隱式提供的全域同步也會消失。
傳統的做法是使用全域屏障:等待每個區塊完成計算並寫入結果後,才允許下一階段繼續進行。
TileRT 避免了這種全域對齊。上游階段一旦產生部分輸出,就可以將資料傳遞給下游階段。下游階段可以等待並逐步處理資料。
透過串流生產者-消費者握手,原本依序執行的階段可以持續重疊,進而減少全域同步引入的延遲。
這種最佳化在 AMD 架構上尤其有效。
2. 使用持久引擎實現更積極的預取
預取是隱藏記憶體存取延遲的關鍵技術之一。 NVIDIA 的 PDL 允許後續核心在前一個核心完全執行完畢之前啟動,從而使資料準備工作能夠更早開始。
TileRT 的持久引擎更進一步,徹底消除了內核邊界。整個前向傳播過程在引擎核心內部持續執行,使得後續階段所需的資料能夠更早開始傳輸,而無需等待「下一個核心」的調度。
這使得 TileRT 能夠控制何時預取、預取多遠以及在整個前向傳播過程中移動哪些數據,從而實現比 PDL 更積極的數據移動和計算重疊。
3. 通訊與計算的融合
對 TP8 來說,all-reduce 也是解碼延遲的關鍵路徑。
傳統實作方式通常將集體通訊作為計算內核之間的獨立操作,使用諸如環形全歸約或歸約-分散+全聚集等演算法。這些方法能夠有效利用鏈路頻寬,但需要多輪通訊和同步。
然而,對於解碼過程中發現的小訊息、對延遲敏感的通訊模式而言,通訊輪數可能比峰值頻寬更重要。
TileRT 則採用一次性推送後進行有序本地歸約的方式:每個 rank 將其資料直接寫入每個對等節點的對稱緩衝區,然後按固定順序在本地執行歸約。這省去了多輪資料傳輸以及單獨的同步階段。
更重要的是,TileRT 中的通訊並非作為獨立內核實現,而是直接整合到執行管線中,使得計算和通訊能夠持續重疊,從而進一步縮短每次前向傳播的關鍵路徑。
為什麼這種方法在AMD上更進一步
這種程度的延遲優化需要突破許多現有的軟體抽象,直接與硬體互動。其效果能達到什麼程度,很大程度取決於架構向軟體開放了多少控制權。
MI355X GPU 背後的 AMD CDNA™ 4 架構提供了多種功能,與 TileRT 的執行模型非常契合。
- 暫存器容量: 預取本質上是一種空間與時間的權衡:資料移動得越早,需要保留的傳輸中狀態就越多,暫存器壓力也就越大。 CDNA 為每個計算單元提供更大的暫存器文件,並為每個執行緒提供更多可尋址的暫存器。對於 TileRT 的持久引擎而言,這意味著在相同的暫存器佔用率下,可以保留更多的傳輸中數據,從而實現更深層的預取和更多的執行階段重疊。
- 分區快取和細粒度記憶體控制: CDNA 架構將 GPU 劃分為多個運算分區,每個分區都有自己的本地緩存,而記憶體指令則允許軟體控制可見範圍和快取行為。這使得分區內的資料塊間交換能夠透過輕量級機制實現,而無需頻繁依賴設備級同步。它自然地映射到 TileRT 的生產者-消費者執行模型:運行時可以明確地決定哪些區塊分組在一起,哪些區塊交換資料。硬體分區成為軟體可以主動利用的局部性層次結構。
- 指令集架構 (ISA) 層面的控制: 一旦最佳化達到持久執行層面,指令調度、記憶體範圍和預取距離等細節就會直接影響端對端延遲。這些決策很難完全交給編譯器。
CDNA 架構讓我們可以透過內聯彙編直接控制最終的指令集架構(ISA)。結合開放且可反彙編的工具鏈,這使我們能夠精確檢查編譯器產生的程式碼,並對效能關鍵路徑進行針對性修改。這為 TileRT 提供了龐大的軟體最佳化空間:硬體提供所需的功能;軟體決定如何排程和組合這些功能。
我們越來越相信,將更多架構能力開放給軟體是應對快速發展的 AI 工作負載的有效途徑。隨著運行時和編譯器對硬體的控制力不斷增強,許多曾經由硬體決定的決策現在可以在軟體層面進行製定和迭代。
TileRT 在 MI355X GPU 上的結果驗證了此方法的有效性。
入門指南及後續步驟
TileRT 已在 PyPI 上發布:
pip install tilert
接下來,我們將朝著以下幾個方向前進:
- 正式發布 AMD ROCm™ 軟體和 MI355X 支援: 我們將在 GitHub 上發布 ROCm 支持,MI355X 將成為 TileRT 官方支援的平台之一。
- 更多批次大小: TileRT 目前專注於將批次 1 的互動性發揮到極致。批次 2、4 及更大批次大小也已列入我們的開發計劃,我們將根據實際工作負載和用戶需求擴展支援範圍。
TileRT 和 AMD 也將繼續在高效能推理方面展開合作。
隨著代理工作負載變得越來越複雜,我們認為推理速度本身將成為擴展性的重要維度。
我們將繼續努力:降低延遲、延長情境時間、更好地利用硬體所提供的功能。
參考
9月搞畏獎開跑中,搞畏有獎放送中 | ioioTIMES 中秋大放送 留言得好禮
現在就加入 ioioTIMES 臉書粉絲團 更多互動、更多好康攏抵加!!
我們有LINE TODAY頻道了,快來追踪我們吧!!--最新科技新聞 盡在你手