最大的風險並非在於今天選擇了錯誤的技術,而是建構的基礎設施無法適應未來的發展
業內人士無法預測五年後的人工智慧會是什麼樣子。
沒人知道下一代主流模型架構會是什麼。沒人知道訓練和推理之間的比例最終會如何決定。也沒人知道有多少人工智慧會在你的資料中心、別人的資料中心,還是你的筆記型電腦(或其他更小的裝置)上運作。但基礎設施領導者至今仍需要做出決策和投資,這些決策和投資將構成未來五到七年企業 IT 發展的基礎。
這就是挑戰所在。事實很簡單:最大的風險並非在於今天選錯了技術,而是在於建置的基礎設施無法適應未來工作負載的變化需求。
在本週的人工智慧基礎設施高峰會上,我提出我們需要重新思考如何設計人工智慧基礎架構。它不應該圍繞著晶片或架構展開,而應該圍繞著一個根本問題展開:當需求改變時,系統能夠多容易地進行調整?
適應性成為設計原則
幾年前,「AI 基礎設施」主要指的是大規模訓練運行,這會對一個大型叢集產生可預測的、批量式的需求。雖然這種工作負載仍然重要,但它現在必須與推理、智能體 AI 以及日益分散、需求各異的工作負載共存。
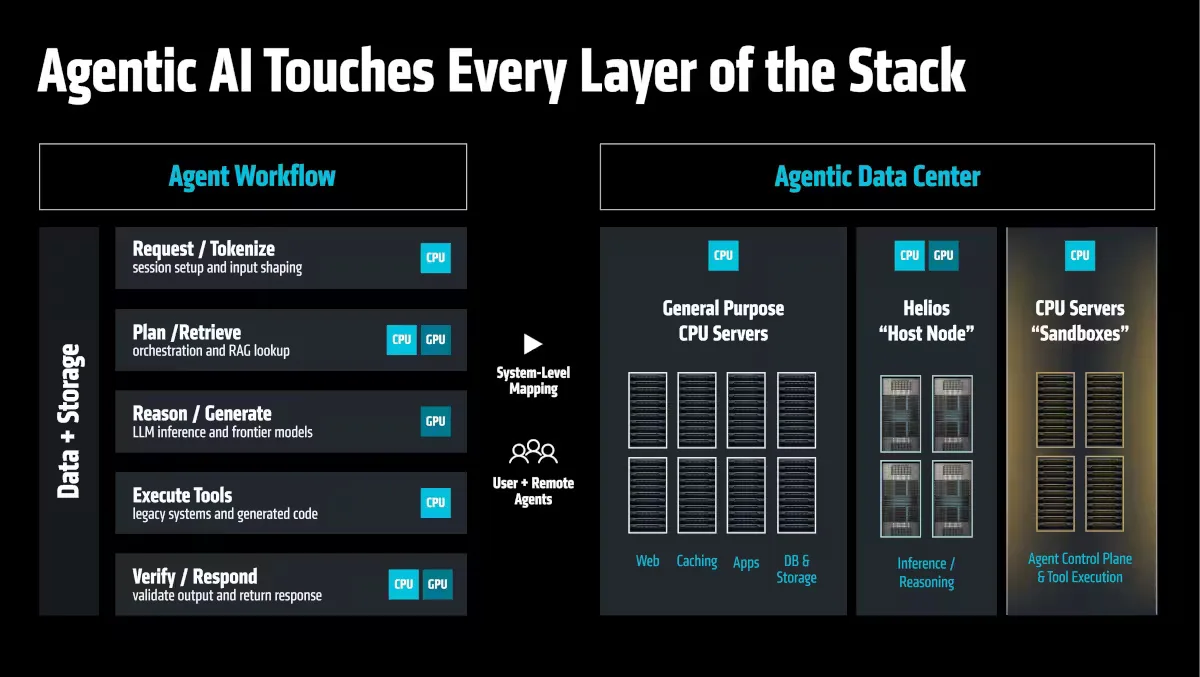
推理過程始終處於開啟狀態,並且非常關注延遲和每次請求的成本。智慧體人工智慧進一步加劇了這種需求,因為一次請求可能演變成一系列步驟:它需要檢索和處理輸入、呼叫工具、執行程式碼、協調子智慧體,並保存比任何單一請求更持久的狀態。
這不僅改變了所需的運算量,也改變了系統的架構。為過去訓練叢集優化的基礎設施不僅容量不足,架構也存在問題:它最初建置時所依據的運算、記憶體和網路比例,如今已無法滿足實際工作需求。而架構問題無法透過增加現有資源來解決。
關鍵在於優化系統,而不僅僅是單一組件。運算、記憶體、網路、儲存、軟體、電源和可靠性都必須協同工作。擴展現有系統屬於預算編制範疇,而引進新系統則涉及架構和維運問題。
讓你自由的三大特質
如果需求不斷變化,那麼設計目標就不是預測最終方案,而是保留向下一步發展過渡的靈活性。在實踐中,這可以歸結為三個可審核的屬性:
適應性強:你需要一個足夠強大的產品組合,這樣當工作負載改變時,解決方案是不同的配置,而不是不同的供應商。將合適的運算資源與適當的任務相匹配,並藉助通用的軟體基礎架構,使這些選擇切實可行。
經濟實惠:這並不意味著便宜——而是指為工作選擇合適的工具。培訓是一項一次性的資本決策;而推理則是一項每天要進行數十億次的營運決策。智能體請求並非一次推理,而是一系列推理的集合,因此需要關注的是完成任務的成本,而不是每個 token 的成本。
開放:開放的生態系統透過廣泛採用的標準提供選擇,使客戶無需依賴單一供應商的產品路線圖。這才是真正的跨供應商選擇,也是開放互連和開放網路如此重要的原因。
AMD產品組合的切入點
這就是為什麼技術的廣度至關重要。這也是為什麼 AMD 投資整個技術堆疊,而不是專注於單一的明星產品。如今的人工智慧需求涵蓋:
● 在 AMD EPYC™ 伺服器 CPU 上進行推理、分詞、編排和其他通用運算,並擴展到 AMD Radeon™ 和 AMD Ryzen™ AI 平台上的小型模型和本地 AI。
● 在 AMD Instinct™ PCIe 卡上進行大型語言模式推理和微調。
● 在八路 AMD Instinct™ GPU 系統上進行分散式推理和訓練,並可擴展到 AMD Helios™ 機架式解決方案,以實現超大規模部署。
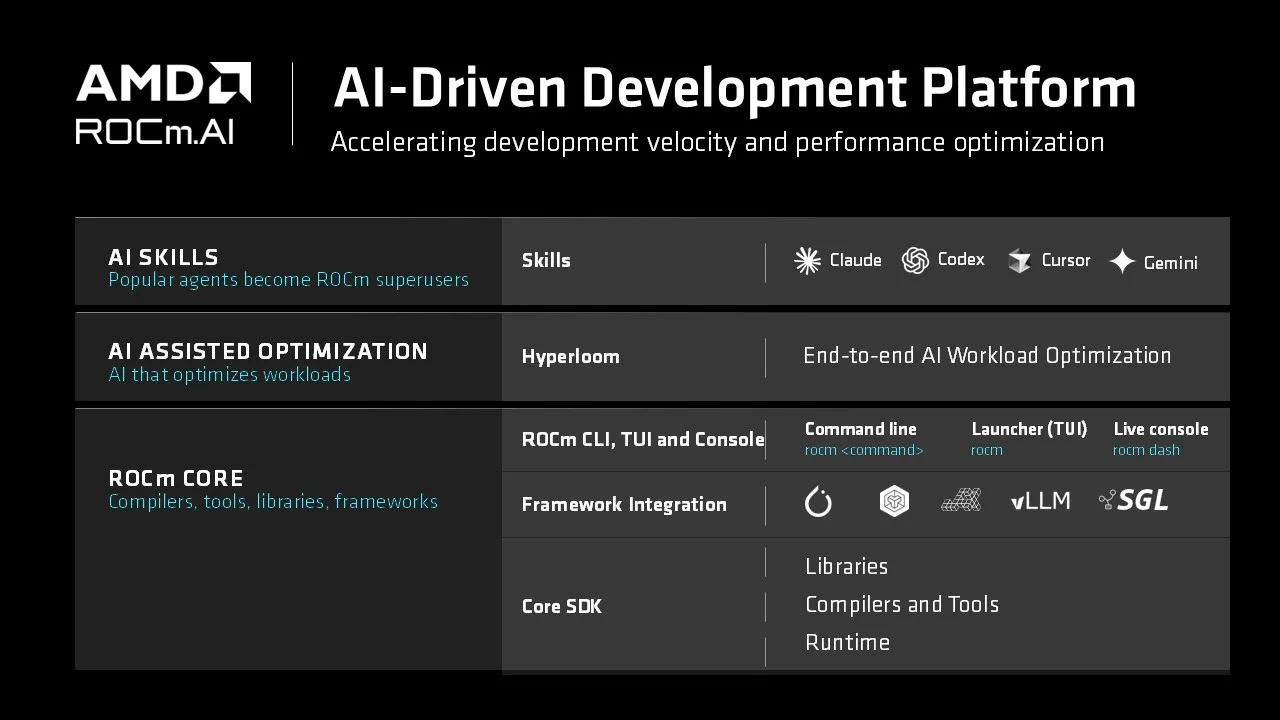
單一產品本身並非重點。缺乏統一的軟體支持,產品線再豐富也只是一堆產品目錄。而有了軟體支持,產品線的豐富性才能帶來真正的彈性。透過 AMD ROCm™ 軟體,工作負載的硬體可以無縫遷移,無需從頭開始。
我們之所以建立全端產品,是因為我們認為每個元件都必須憑藉自身優勢取勝,而不是因為只有購買所有元件才能讓整個堆疊發揮作用。開放標準使這一切成為可能:選擇最適合您工作負載的 AMD 組件,並保留在其他方面進行不同選擇的自由。
未來五年表現優異的組織,不會是那些能夠預測所有趨勢的組織,而是那些擁有足夠的自由度和靈活性,能夠在情況需要時及時做出調整的組織。
建構適應性強的系統,這樣無論未來如何變化,都能適應。建立經濟高效的系統,這樣你就能為合適的工具買單,而不是為最大的工具買單。建立開放的系統,這樣才能保留選擇權——因為如果你不這樣做,你將為此付出代價。
我們可以肯定的是,人工智慧將不斷發展變化。我們從一開始就應該基於這個假設來建立基礎設施。
(作者:Forrest Norrod,資料中心解決方案業務集團執行副總裁兼總經理)
中秋節好康活動火熱響應-「中秋團圓、電腦也團圓」快來留言拿大獎!!
9月搞畏獎開跑中,搞畏有獎放送中
現在就加入 ioioTIMES 臉書粉絲團 更多互動、更多好康攏抵加!!
我們有LINE TODAY頻道了,快來追踪我們吧!!--最新科技新聞 盡在你手