UltraQuant 能夠在負載下提高解碼吞吐量並降低延遲,同時不會顯著降低推理準確率。在本 blog 中,我們將向您展示如何在配備 Qwen3.8-2.4T MXFP4 的 AMD Instinct GPU 上,將 UltraQuant 應用於長上下文和代理 LLM 服務。一旦代理程式提示達到數十萬個詞元時,鍵值 (KV) 快取將成為效能瓶頸,而非運算能力。多輪代理(長共享前綴、短迭代週期、高並發性)受此瓶頸的影響尤為嚴重。
我們將 AMD Quark 的 MXFP4 Qwen3.8 檢查點與 vLLM 上的 UltraQuant 結合使用。兩者相互獨立:MXFP4 縮小模型權重,UltraQuant 將鍵值快取縮小到 4 位元。在實際的智慧體回放測試中,UltraQuant 在負載下能夠以更低的延遲處理比標準 8 位元快取更多的流量,同時保持精度不變。
關鍵成果
-
負載下速度更快:在並發數 C=32(32 個正在處理的請求)下,UltraQuant 每秒處理的詞元數量比最快的 8 位元 KV 後端高 29%,每個詞元的延遲低 24%,並且返回第一個詞元的速度快 1.7 倍。在輕負載下,兩者性能相當;隨著並發數的增加,差距逐漸拉大,因為 UltraQuant 在每個解碼步驟中移動的內存只有讀取量的一半。
-
MTP 運行於其上:Qwen3.8 的 Multi-Token 預測頭現在與 UltraQuant 配合使用,在 C=16 時將 Token 間延遲進一步降低 12-22%。當 C=32 時,速度會變慢,因此在適中的並發量下保持 MTP 開啟,在高負載下將其關閉。
-
準確性保持不變:無論是否啟用 MTP,GPQA-Diamond 和 SWE-bench Lite 的結果均在 8 位元快取的取樣雜訊範圍內。各基準測試的具體數值如下。
-
建議:在 AMD Instinct 上使用 UltraQuant 為 Qwen3.8-MXFP4 提供長時間情境代理服務,僅在對延遲敏感、並發性較低的部署中加入 MTP。
型號:Qwen3.8-2.4T-A95B,MXFP4
Qwen3.8 是一個擁有 2.4 兆個參數的混合專家模型(每個 token 約有 950 億個活躍參數),上下文視窗大小為 26.2 萬。一些細節使其成為 KV 快取工作的一個有趣測試:
-
這是一個混合模型:92 層中只有 23 層保留了傳統的 KV 快取;其餘層使用輕量級循環狀態,因此 KV 壓縮佔用的空間較小,但在長時間上下文中仍然很重要,因為這 23 層具有較大的每個標記的快取。
-
權重是 MXFP4(AMD Quark),它在 MI355X 上原生運作。
-
它配備了一個用於推測性解碼的 MTP 頭,我們將在下面單獨進行測試。
什麼是UltraQuant?
UltraQuant 是 AMD 為上下文密集型智能體開發的 4 位元 KV 快取方法(arXiv:2606.20474 (https://arxiv.org/abs/2606.20474))。它將鍵和值儲存在 MI355X 已支援的 FP4 網格上,每 32 個通道組成一個共享的 2 的冪次方級。一個頻道組佔用 17 字節,而 8 位元快取則佔用 32 字節,因此每次解碼步驟大約讀取一半的記憶體。
達到 4 位元精度需要一個準備步驟:Walsh–Hadamard 旋轉,該旋轉可以分散異常值通道,從而使 4 位元網格能夠很好地表示分佈。本文詳細介紹了這一步驟及其背後的精度分析。
這種格式的實用之處在於,在矩陣乘法運算之前無需進行任何解包運算。在 MI355X (CDNA4) 上,矩陣核心直接接受 FP4 值作為 MFMA 操作數,並且由於 MXFP4 的縮放比例是 2 的冪,因此應用該比例會被整合到縮放後的 MFMA 指令本身中,而無需單獨的反量化步驟。因此,鍵值張量 (K/V 張量) 始終保持 FP4 格式,直到矩陣核心執行。基於擬合碼本的壓縮方案則不具備此特性:它們的壓縮級別是任意的,因此內核必須透過查找表收集這些級別,並在暫存器中重建鍵值對,然後才能進行乘法運算。 UltraQuant 則在原生 FP4 路徑上解碼,避免了使用查找表,這在記憶體受限的情況下非常有用。
在所有實驗中,模型權重均保持為 MXFP4 格式,只有鍵值快取發生變化。在 Qwen3.8 的混合設計中,UltraQuant 應用於實際持有快取的 23 個全注意力層。
代理服務
工作負載和設定
我們重現了一個真實的 SemiAnalysis (InferenceX) 代理追蹤:共享前綴很長(提示符通常包含數萬到數十萬個標記),輸出很短,每個會話包含多個回合。兩種設定都查看完全相同的跟踪,並使用來自 Qwen3.8 型號顯示卡的相同採樣設置,只有伺服器配置不同。我們在 AMD Instinct MI355X ×8 上運行,使用 vLLM v0.19.2rc0 以及本文中使用的 UltraQuant 內核、AITER 0.1.16.post3 和 FlyDSL 0.2.0,上下文大小為 262K,啟用前綴緩存,並發數 C 分別為 4、8、16 和 32、16 和 32、16 和 16 和 16 和 16 分別為 32。在所有設定中,前綴快取命中率都保持在 91% 到 95% 之間。
我們將 UltraQuant(4 位元 KV 快取)與 8 位元 KV(標準 FP8 快取)進行比較。由於 8 位元快取可以運行在多個注意力機制後端,因此我們在 ROCm 的兩種 AITER 核心(統一核心和 FA 核心)上都運行了該緩存,並將 UltraQuant 與給定負載下性能更強的核心進行比較。
UltraQuant與8位KV
圖 1 將並發數從 4 掃到 32。我們展示了 ROCm 的兩個 AITER 注意力後端(統一和 FA)的 8 位緩存,因此在每個點上都是與兩者中較好的一個進行比較。
在輕負載下,三條曲線幾乎重疊。隨著負載增加,差距逐漸拉大:UltraQuant 的效能持續攀升,而兩個 8 位元後端的效能則逐漸落後,並且兩者在過程中互換位置。 Unified 在 C=16 時領先,但之後趨於平緩,而 FA 在 C=32 的壓力點表現更佳。在整個測試曲線的上半段,UltraQuant 的性能始終領先兩者。
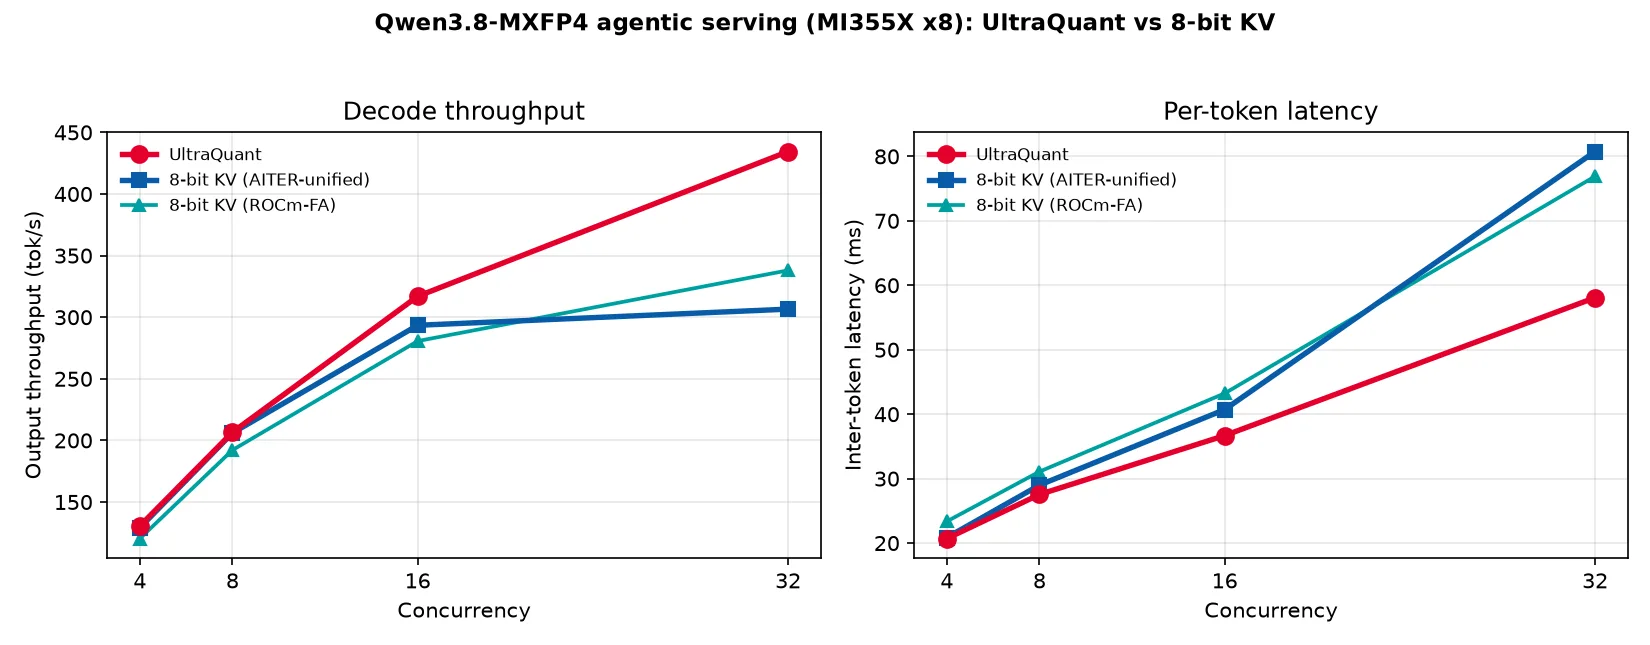
在 C=32 時,UltraQuant 的吞吐量達到 434 tok/s,延遲為 58 ms,而通常速度更快的 8 位元後端 ROCm-FA 的吞吐量為 338 tok/s,延遲為 77 ms。 UltraQuant 的吞吐量提高了 29%,單詞元延遲降低了 24%。與 AITER-unified(307 tok/s,延遲為 81 ms)相比,UltraQuant 的吞吐量提高了 41%,單詞元延遲降低了 28%。
為什麼UltraQuant能超越8位元KV
這項優勢體現在兩個方面。首先是容量:UltraQuant 每快取 32 個值只需 17 字節,而 FP8 則需要 32 字節,容量減少了 47%(每字節可快取的值增加了 1.88 倍)。這意味著在 HBM 成為瓶頸之前,可以保留更多長期存在的代理上下文。其次是頻寬:每個新詞元都會重新讀取整個緩存,因此更小的快取意味著需要獲取的資料更少。
僅靠壓縮是不夠的:如果核心必須以軟體方式解包每個值,那麼節省下來的頻寬就會被用來尋找。 UltraQuant 透過將 FP4 碼和 UE8M0 縮放映射到原生 CDNA4 操作來保留節省的頻寬。這就是為什麼圖 1 在 C=4-8 時效能均衡(此時還有剩餘的運算資源來隱藏額外的流量),以及為什麼 UltraQuant 在 C=32 時效能顯著提升(此時許多長上下文會話同時解碼,記憶體頻寬成為瓶頸)。核心級屋頂線展示了這個機制。圖 2 單獨分析了解碼注意力步驟,並展示了上下文從 8K 成長到 32K 的過程。
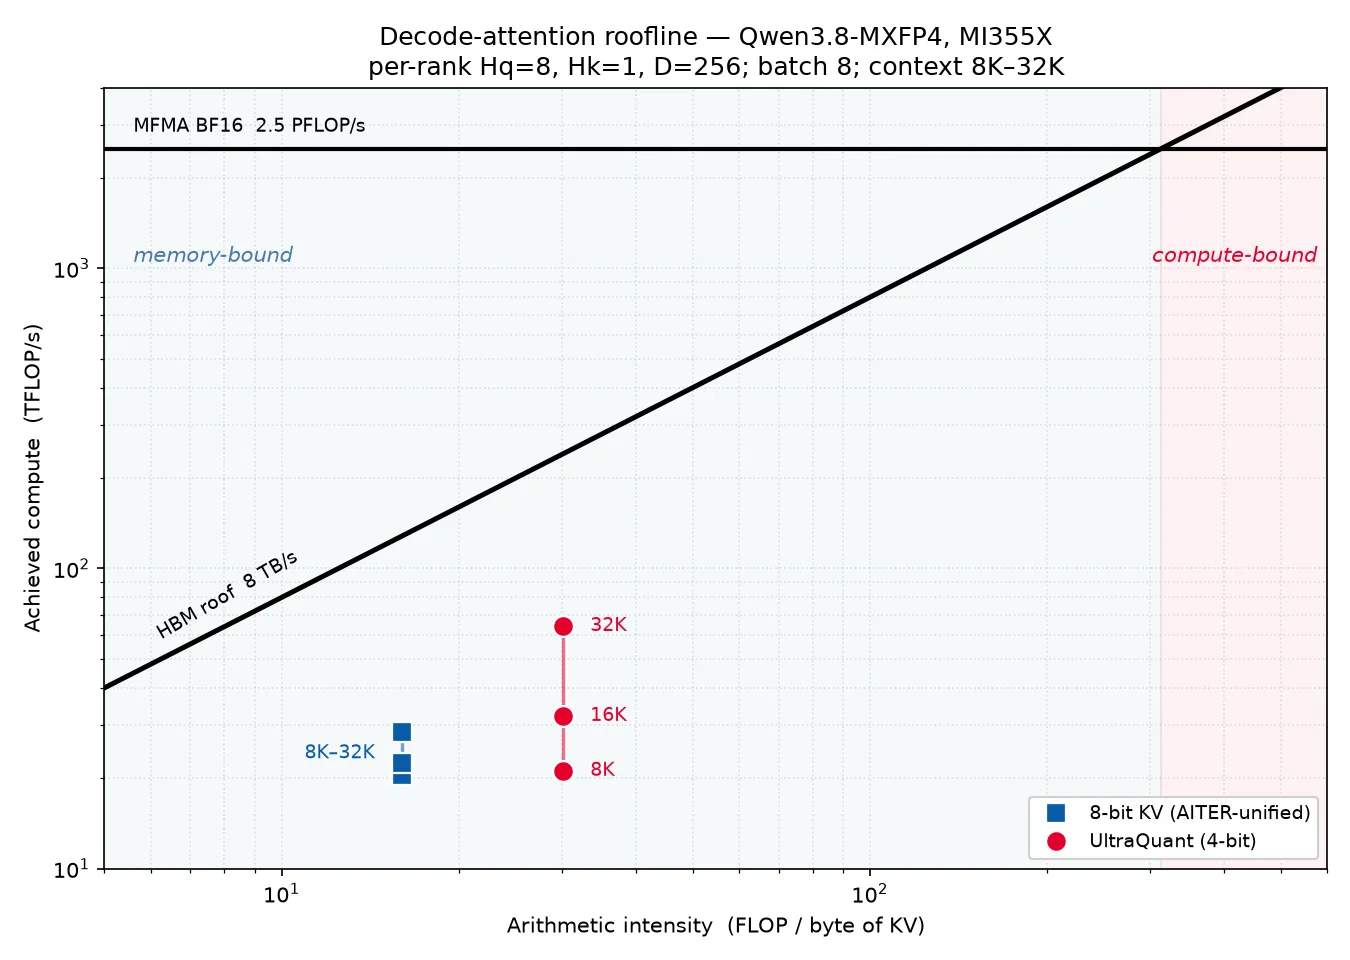
每個值佔用的位元組數越少,這意味著每位元組快取可以進行更多的注意力計算,因此 UltraQuant 的記憶體佔用量更高。隨著上下文的成長,它的記憶體佔用也隨之增加,運算能力提升三倍,而 8 位元快取保持不變。兩者都不會使 HBM 記憶體飽和;優勢僅在於需要等待的位元組數更少。在 32k 上下文長度下,解碼注意力步驟的速度提高了 2.25 倍。
前綴快取命中率已經很高且相近(圖 1 中為 91%–95%),因此 C=32 的差距並非由於 8 位元鍵值快取被驅逐並重新預填充所致。兩種格式都保持駐留,並且由於本次測試不需要,因此我們沒有使用鍵值快取卸載。解碼速度更快,因為注意力核心在原生 FP4 路徑上每個標記移動的位元組數更少(圖 2:32K 時速度提升 2.25 倍)。 Qwen3.8 也限制了效能提升,因為 92 層中只有 23 層具有鍵值快取。
吞吐量與延遲的權衡
由於吞吐量和單詞元延遲之間存在天然的權衡關係,因此最公平的比較方法是使用帕累托前沿:即在任何給定的詞元間延遲下,解碼吞吐量所能達到的最高值。圖 3 繪製了 UltraQuant 和 UltraQuant + MTP 與 ROCm-FA、AITER-unified 以及 ROCm-FA + MTP 上的 8 位元快取的這種權衡關係。圖中,越靠左上方表示效能越好,每個標籤代表一個並發等級。
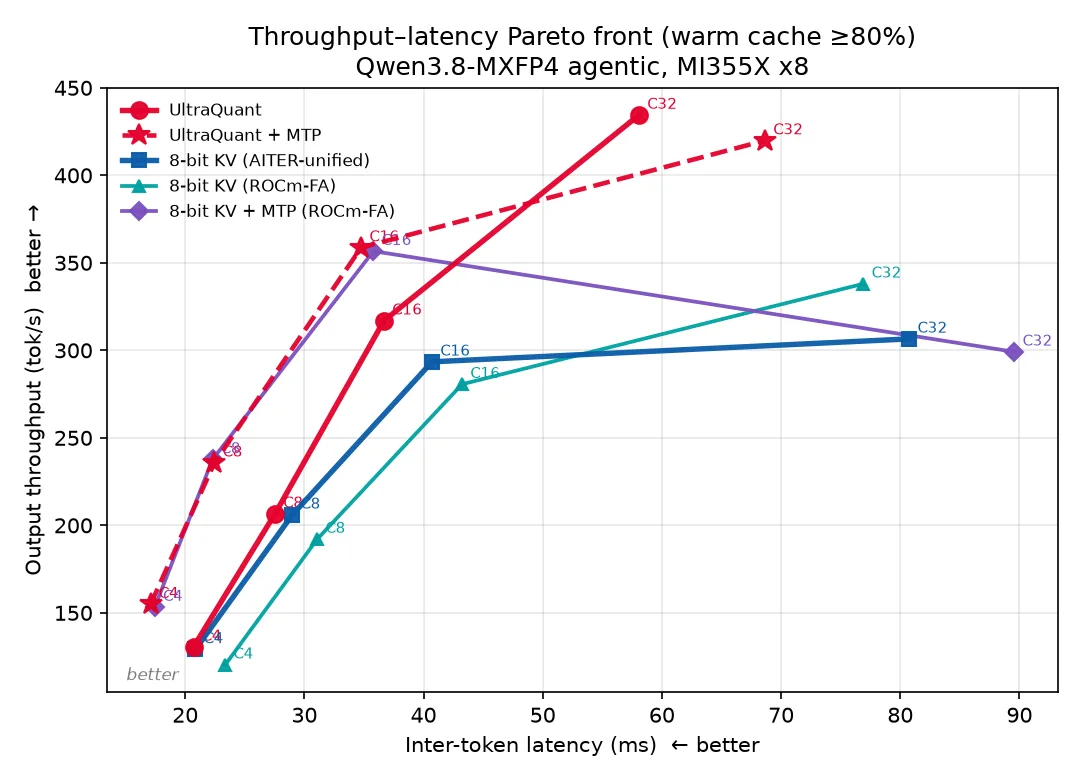
MTP 在併發量適中時效果最佳。驗證步驟雖然增加了工作量,但提交的詞元數量約為 2.3 個,而不是 1 個。在併發量 C=16 時,UltraQuant + MTP 是我們運行過的延遲最低的配置,比純 UltraQuant 低 12% 到 22%,並且在並發量 C=4 時請求完成速度提高了約 30%。
當 C=32 時,MTP 的兩個分支(UltraQuant 和 8 位元)的效能都出現倒退。每個驗證步驟會記錄三個位置,並保留約 2.3 個詞元,因此每個已發出詞元的工作量比單一詞元解碼大。在低併發情況下,這些額外的工作量成本很低,步驟更少即可勝出;但在 C=32 時則不然。接受長度保持在約 2.3,且每個分支的前綴快取命中率都在 91%–95% 之間,因此草稿和快取並非導致效能下降的原因。
此處測試的 UltraQuant + MTP 路徑功能正常,但尚未實現融合的多標記解碼。 vLLM 將每個驗證批次擴展為 B×K 個單標記查詢行。這些查詢行共享一個分頁鍵值快取並同時執行,但 UltraQuant 目前的解碼核心將它們作為獨立的查詢進行處理,因此無法在 K 個候選位置之間復用快取讀取。相較之下,8 位元 MTP 路徑使用了 AITER 的融合 K 查詢 unified_attention 核心。在 C≤16 的情況下,MTP 仍然優於 UltraQuant,因為每個驗證步驟接受約 2.3 個標記可以減少足夠的順序解碼輪次,從而抵消未融合注意力機制帶來的工作量。融合 K 查詢的 UltraQuant 核心可以在候選位置之間共用快取讀取,這為進一步最佳化提供了機會。
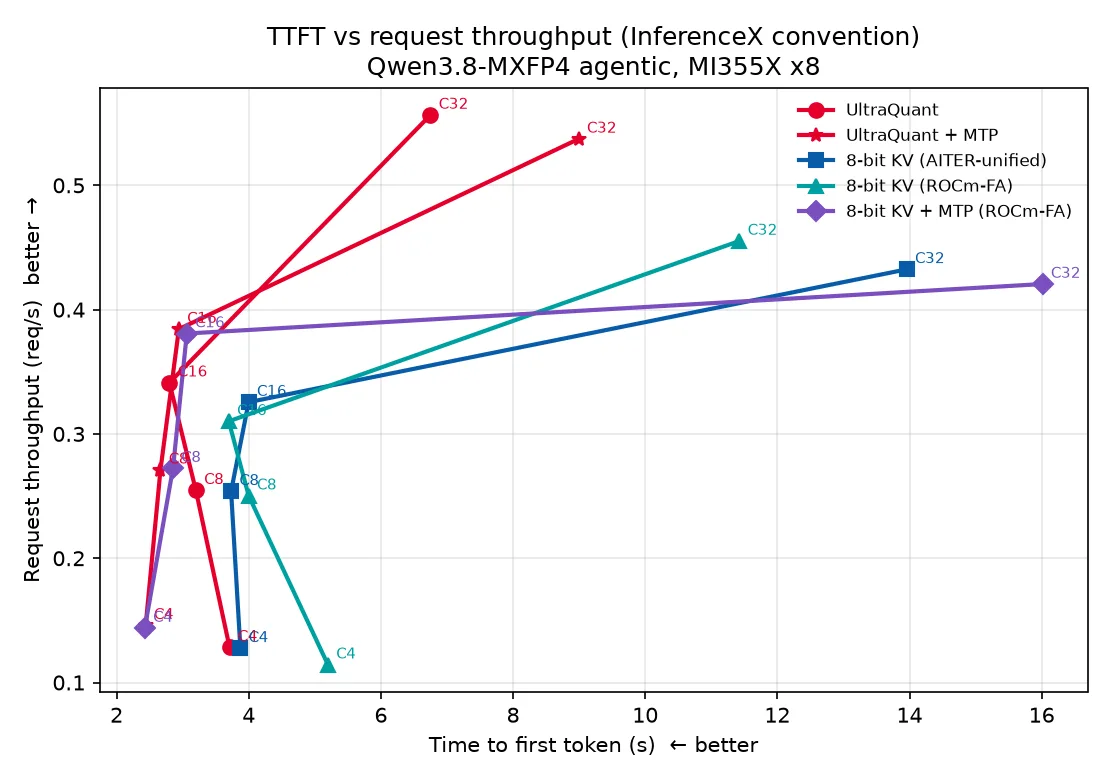
除了解碼吞吐量和詞元間延遲之外,代理服務還取決於每個請求返回第一個詞元的速度以及系統能夠承受的請求數量。圖 4 繪製了所有後端和並發情況下的首次詞元返回時間與請求吞吐量的關係圖;曲線越靠左上方表示效能越好,每個標籤代表一個並發等級。
準確度:GPQA-鑽石
我們在 GPQA-Diamond 資料集(198 題)上評估推理質量,保持權重和採樣不變,僅改變 KV 快取。 UltraQuant 的性能與 8 位元基準相比,處於採樣雜訊範圍內。
方法論。所有精度測試和 SWE 基準測試均使用 Qwen3.8 模型卡,溫度設定為 1.0,且每個臂的取樣率相同。我們報告精度和分辨率,並根據採樣噪音判斷間隙。如果某個配置在多個種子上運行,我們報告所有種子的平均值;如果同一個種子重複運行,我們報告這些運行的平均值。
|
配置 |
準確性 |
|---|---|
|
8 位元 KV |
94.4% (187/198) |
|
8 位元 KV + MTP |
92.9% (184/198) |
|
超定量 |
92.9% (184/198) |
|
UltraQuant + MTP |
91.4% (181/198) |
UltraQuant 在 8 位元快取下的得分為 92.9%,而 8 位元快取下的得分為 94.4%,兩者相差 1.5 分,即 198 題中的 3 題。啟用 MTP 後,兩種格式的得分均相差 1.5 分。四個分支的總分差為 3 分,小於兩個 UltraQuant + MTP 種子之間的 4 題差距,因此此分差與抽樣變異數一致,GPQA-Diamond 在此樣本量下無法區分 KV 格式。
準確度:SWE-bench Lite
SWE-bench Lite 對端到端的軟體工程任務解決進行評分。對於每個 GitHub 問題,該代理程式會檢查程式碼庫,經過多次編輯,並提交一個由專案測試評分的補丁。我們使用與服務掃描相同的四個鍵值對配置,在一個包含 100 個任務的固定子集上進行評估,並報告解決率(已解決任務數/100)。
|
配置 |
無 MTP |
+ MTP |
|---|---|---|
|
8 位元 KV |
78 |
81 |
|
超定量 |
81 |
88 |
UltraQuant 解析了 81/100 個任務,而 8 位元快取的解析率為 78/100,儘管快取儲存量僅為每個詞元預算的一半,UltraQuant 仍比 8 位元基準高出 3 個任務。啟用 MTP 後,兩種格式的解析率分別達到 81/100 和 88/100,因此在兩種設定下,4 位元快取均與 8 位元快取持平或更優,且所有配置的解析率均未低於 8 位元基準。每個條目都是固定佇列的單次遍歷,3 到 7 個任務的差距與我們在 GPQA-Diamond 上測量的種子到種子之間的差異相當,因此我們認為這四種配置在任務解析方面是等效的。
概括
在本篇部落格中,您了解了 UltraQuant 如何將原生 4 位元 KV 快取引入 AMD Instinct 平台上的 Qwen3.8-MXFP4 長上下文代理服務,以及它在實際代理工作負載下與標準 8 位元快取的效能比較。簡而言之,您可以在不犧牲推理準確性的前提下,以更低的延遲處理更多流量。
在 C=32 時,UltraQuant 相對於性能最強的 8 位元後端,解碼吞吐量提升了 29% ,每個詞元的延遲降低了 24%,返回第一個詞元的速度提高了 1.7 倍,並且在 32K 上下文中,僅解碼步驟的運行速度就提高了 2.25 倍。在 C≤16 時,疊加 Qwen3.8 的 MTP 頭部,詞元間延遲進一步降低了12%–22%,且沒有系統性的準確性損失。在 GPQA-Diamond 和 SWE-bench Lite 測試中,無論是否使用 MTP,4 位元快取的效能都保持在 8 位元快取的取樣雜訊範圍內。
那麼 UltraQuant 在您的技術棧中扮演什麼角色呢?對於在 AMD Instinct 平台上運行 Qwen3.8-MXFP4 的長上下文代理服務而言,UltraQuant 是一個不錯的預設選擇;如果您的工作負載對延遲敏感且並發性較低,那麼 UltraQuant + MTP 則是最佳配置。
未來仍有幾個方向可供探索:
-
融合多詞元 UltraQuant 解碼,因此 MTP 驗證可以跨候選位置重複使用每次快取讀取,而不是展開多個單一詞元查詢。
-
將 UltraQuant 上游整合到 vLLM 中,以便此處測量的核心和服務路徑進入公共樹。
-
在全注意力模型上重複掃描,其中更多層保存快取。
致謝
我們要感謝 AMD 核心、量化和推理服務團隊的同事們,以及開源 vLLM 社區,他們的上游工作和技術討論使這項研究成為可能。
(本文由 Google 翻譯,原文網址為在此)
(作者:Aditi Ghai Rana、Bowen Bao、David Limpus、Spandan Tiwari、Thiago Crepaldi、Ashish Sirasao)
9月搞畏獎開跑中,搞畏有獎放送中 | ioioTIMES 中秋大放送 留言得好禮
現在就加入 ioioTIMES 臉書粉絲團 更多互動、更多好康攏抵加!!
我們有LINE TODAY頻道了,快來追踪我們吧!!--最新科技新聞 盡在你手