邊緣智慧AI:透過AMD Ryzen AI嵌入式X100系列處理器超越TOPS
傳統的邊緣 AI 遵循線性流程:擷取影像、運行推理、觸發操作。而智能體 AI 則以意圖、情境、規劃、工具使用以及服務間協作的循環取代了這個流程。 GPU 效能仍然重要,但它不再是全部。 CPU 負責協調整個循環,處理網路通訊、資料解析、影像預處理和決策邏輯,而嵌入式應用程式的其餘部分則在其下繼續運作。
設想一台工業嵌入式 PC 部署在工廠的品質控制檢測站。傳統系統會標記缺陷並發出警報。而智能體系統則能辨識異常,追蹤上游製程偏差,通知相關技術人員,並建議是否暫停生產線。檢測轉變為協同行動,一個模型變成了一組相互協作的服務。正是這種轉變使得平台選擇更加困難,因為峰值 TOPS 值並不能很好地反映系統在所有服務同時運作時的實際表現。
當一個代理人變成一百個代理人
智能體部署規模通常很小。單一工廠邊緣節點可以協調數百個綁定到特定感測器流、機器或策略域的輕量級智慧體。這些智能體並非等待人工提示的複雜對話模型,而是專門的微型智能體,它們會在事件發生時被喚醒,檢索所需信息,調用工具,並將結果返回。每個智能體都會增加 CPU 的資源,用於資訊檢索、提示組裝、服務路由、策略檢查、遙測和異常處理等操作。隨著智慧體數量從單一機器上的數十個增長到整個工廠的數百個,這些操作之間會產生重疊。現代設計需要預留擴展空間,而不僅僅是滿足初始部署的工作負載。
幾乎所有市場都呈現相同的模式。自主移動機器人車隊將感知、導航和車隊協調功能分佈在車輛和倉庫基礎設施中。醫療系統將影像、設備分診和工作流程指導結合,同時將病患資料保存在院內。網路網關並行運行流量分析、深度檢測和日誌處理。在所有情況下,孤立的模型基準測試只能描述實際工作負載的一小部分,因為平台必須同時支援推理、網路、加密、儲存和控制邏輯。
mimOE與Ryzen™ AI Embedded X100:作業系統與晶片的融合
mimik 透過 Agentix 原生系統軟體架構實現邊緣 AI。其邊緣原生平台將智慧分佈在裝置、服務和本地環境中,而不是強制所有請求都通過集中式雲端點。 mimik 將這種架構稱為「設備優先連續體 AI (DFC-AI) 和運算」。智慧在資料產生的地方運行,上下文與現實相符,並且操作可以在整個連續體中流暢執行——從終端設備到邊緣節點,並在必要時到雲端。這種模型在連線不穩定、頻寬受限或資料駐留不可協商的情況下至關重要。
mimik Agentix 作業系統引擎 (mimOE) 為在連線受限環境下運作的多代理、多租戶邊緣環境提供必要的編排、協調和安全性。在軟體層,mimOE 透過將代理程式作為微服務運行來最大限度地提高效率,這些微服務共享公共運行時和駐留模型實例。透過消除重複的模型複製,記憶體根據載入的不同模型的數量進行擴展,而不是根據代理的數量。
mimOE 的優勢只有在選擇合適的平台時才能真正發揮出來。 AMD Ryzen™ AI Embedded X100 系列將 x86 CPU 核心、整合式顯示卡、NPU 和統一記憶體整合到一個長生命週期的嵌入式處理器中,使 mimOE 能夠在同一裝置上同時擁有足夠的 CPU 資源用於編排,以及用於推理的加速器。在 455 種智慧體 AI 工作流程組合的 mimik 建模中,Ryzen AI Embedded X100 處理器配置支援的並發智能體數量比 NVIDIA® Jetson T5000 級配置高出 2.3 倍。1這優勢的來源與數量本身同樣重要。編排是分支繁多、對延遲敏感的控製程式碼,它運行在 CPU 核心上而不是 GPU 上,因此,一個幾乎完全專注於推理吞吐量的平台,在 TOPS 額定值達到上限之前,就會在編排方面遇到瓶頸。
這也是以 GPU 為中心的 SoC 面臨的挑戰。 NVIDIA Jetson 平台將強大的 GPU 與相對較弱的 CPU 搭配使用:不支援同步多線程,且單核心效能較低,一旦工作負載從簡單的推理轉變為編排,就會成為一個真正的瓶頸。 Intel® Core™ Ultra 處理器將 CPU 工作分配到效能核心和效率核心上,這種調度模型使得部署代理程式編列產生的對延遲敏感的控制邏輯更具挑戰性。
統一記憶體保持代理上下文移動
多智能體系統會建立和使用大量的上下文資訊:提示、嵌入、中間張量、感測器元資料、日誌、影像、解碼後的媒體、工具回應和應用程式狀態。在不同的 CPU 和 GPU 記憶體域之間傳遞這些資料會增加副本和同步點,而每次都會增加延遲、頻寬、功耗和工程時間。
Ryzen AI Embedded X100 系列處理器採用統一記憶體架構,使 CPU、GPU 和 NPU 能夠共享相同記憶體池,記憶體頻寬高達 273 GB/s,在 STREAM 基準測試中,其持續吞吐量比 Intel Core Ultra 系列 3 CPU 高出 1.3 倍。2在多智能體節點中,可用頻寬通常決定了上下文視窗、檢索資料、感測器緩衝區和本地模型執行能否共存而不互相干擾。它還能縮短感知、推理和行動之間的路徑。 GPU 可以進行視覺和平行運算,NPU 可以有效率地進行推理,而 CPU 則可以保持應用程式的反應速度,同時 mimOE 路由在邊緣環境中運行,智慧體共享相同的駐留資料。
x86技術與AMD ROCm™軟體:超越設計週期的程式碼
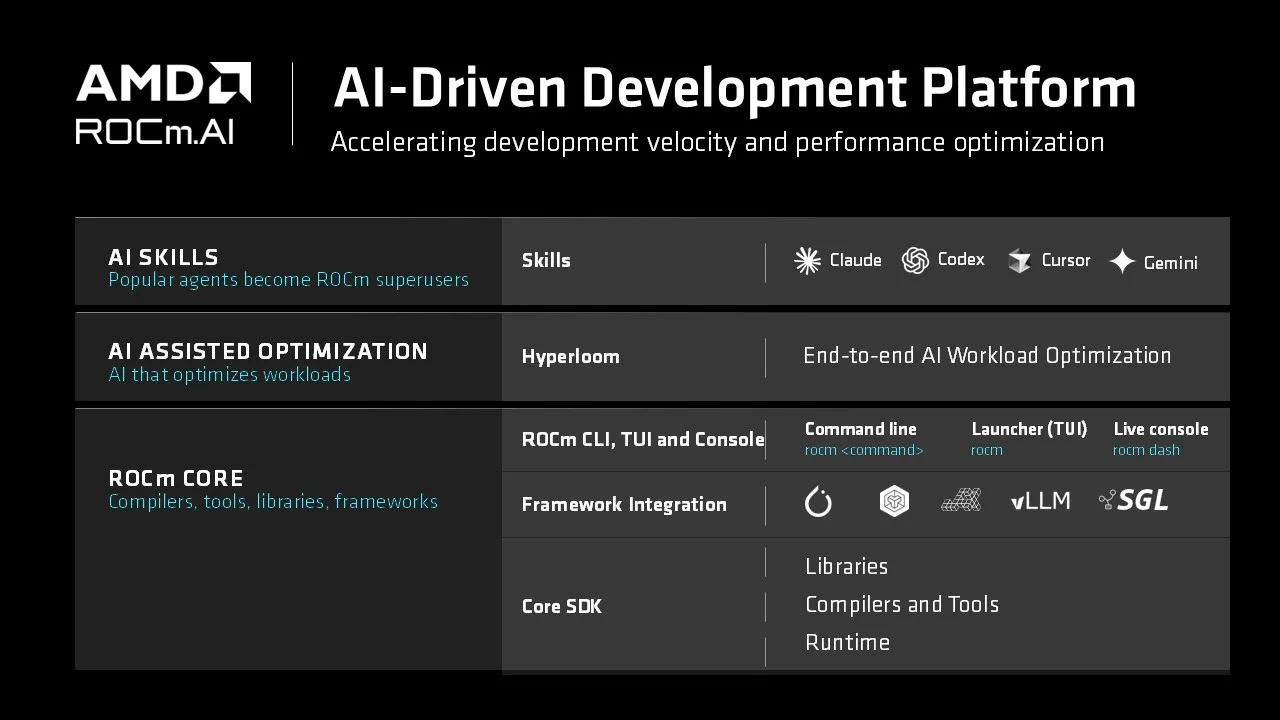
嵌入式系統需要長期服役,因此軟體堆疊必須能夠支援產品生命週期內不斷演進的應用、模型和需求。 AMD 透過提供完整的 x86 平台以及開源的 AMD ROCm™ 軟體來解決這個問題,從而使設計的晶片和軟體選擇能夠滿足其多年需求,而不僅僅是一個產品週期。智慧型體 AI 通常是現有嵌入式產品的擴展,而不是從零開始重新設計,因此將應用層、中介軟體和作業系統層保留在 x86 架構上可以減少需要重寫和重新驗證的程式碼量。工業設計還取決於規格表無法涵蓋的因素,例如產品的長期可用性和對已部署設備的長期軟體支援。
這種延續性不僅限於您自己的程式碼庫。與典型的嵌入式應用程式相比,智慧體系統需要呼叫更多第三方工具、函式庫和 SDK,而該生態系統中的絕大多數仍優先考慮 x86 架構。堅持使用 x86 架構意味著,當智能體呼叫尚未在其他平台完全移植和驗證的新工具、模型執行時間或供應商 SDK 時,可以減少意外情況的發生。
這種連續性不僅限於已在使用 x86 架構的團隊。對於來自 NVIDIA CUDA® 生態系統的團隊,AMD ROCm 軟體和 HIPIFY 工具提供了一條切實可行的遷移路徑。在 AMD 針對基礎 GPU 工作負載的內部測試中,ROCm HIPIFY 平均保留了 83% 的 CUDA 程式碼,在運算密集型應用中保留了 71%,在 AI 和機器學習工作負載中保留了 72%。 ³驗證和調優仍然需要進行,但大部分現有程式碼庫可以隨設計一起遷移。更多詳情,請參閱「從 CUDA® 到 AMD ROCm™ 軟體,無需從頭開始」。
這種面向長遠的設計理念也延伸到了晶片本身。 Ryzen AI Embedded X100 系列處理器專為長達 10 年的 24/7 全天候運行而設計,部分 SKU 支援 -40°C 至 105°C 的溫度範圍,因此,智能體設計背後的平台可以設計成能夠在嚴苛的環境中運行,並隨著其上運行的軟體的不斷演進而持續穩定運行。
Ryzen AI嵌入式X100處理器將為您帶來什麼
您的設計將提升單節點效能。 一個 Ryzen AI Embedded X100 處理器節點能夠承載多個負載平衡度較低的系統的工作負載,這意味著所需的節點數量可以更少。在規劃設計方案時,應根據預期同時運行的代理程式、模型和服務數量來確定規模,而不是僅針對 GPU 的峰值 TOPS 值。
隨著代理數量的增加,您的投資將得到保障。在產品的生命週期內,隨著新模型、新服務和新監管要求的出現,代理數量會不斷增長。由於 Ryzen AI Embedded X100 系列處理器讓您繼續使用熟悉的 x86 程式碼和開源的 ROCm 軟體,這種成長可以透過對已部署硬體進行軟體更新來實現,而無需針對每個新的工作負載進行重新設計。您還應該了解,這些優勢不僅限於邊緣節點。 AMD EPYC™ 處理器以同樣的方式擴展了代理 AI 的並發性。
回報顯而易見:AMD Ryzen AI Embedded X100 系列處理器和 mimik mimOE 你的下一個設計將會超越人工智慧接下來所做的一切。
(作者:Quenton Hall,AMD自適應與嵌入式運算事業部產品管理資深經理)
1. 基於 AMD 委託 mimik 撰寫的白皮書《異構 SoC 上生產級智能 AI 的架構適配性》(Architectural Fit for Production-Scale Agentic AI on Heterogeneous SoCs),該白皮書於 2026 年 7 月 23 日發布,其基於對兩類設備(XIA 100 和 TJet 50505450542 TJet 250505050 45050 45050 450250250 45050 的工作流程的建模測試,並考察了 CPU、GPU 和記憶體的剩餘資源。更多資訊請見:https://www.mimik.com/agentix-compute-benchmarking(REX-019)
2. 本次測試由 AMD 於 2026 年 5 月在配置符合 Ryzen AI Embedded X100 系列規格的 AMD Ryzen AI Max+ 395 (OPN 100-000002199) 上進行(STAPM 已停用;SPL 45W;sPPT 45W;fPPT 6445W; (30W;PL1 45W;PL2 64W;LPDDR5X-8533) 進行比較。結果反映了在 Ubuntu® 24.04 系統下,STREAM (GCC 15) 測試的相對幾何平均效能。系統製造商可能會採用不同的配置,從而導致不同的結果。實際結果可能因配置、設定、使用情況和其他因素而異。 (REX-009)
3. 根據 AMD 截至 2026 年 4 月的內部測試,並在 AMD Ryzen AI Max+ 395 處理器(作為 AMD Ryzen AI Embedded X100 系列 CPU 的代表)上進行了驗證,一個包含 15 個 CUDA 範例應用程式(共 1199 行程式碼)的 CUDA 到 HIP 驗證已從 HCUDA 到 HCUDA 遷移到 HCUDA。代碼保留率以 HIP 轉換後保留的原始 CUDA 原始碼的百分比來計算。基礎工作負載包括 saxpy、矩陣轉置、直方圖、影像模糊和前綴和。運算密集型工作負載包括 warp reduction、N 體、SpMV、多流和 cuBLAS GEMM。 AI/ML 工作負載包括 softmax、層歸一化、注意力機制、卷積和基數排序。實際結果可能會因應用程式複雜度、CUDA 程式庫使用情況、架構特定最佳化、底層 CUDA 結構、轉換後所需的程式碼修改或其他因素而有所不同。 (REX-020)
9月搞畏獎開跑中,搞畏有獎放送中 | ioioTIMES 中秋大放送 留言得好禮
現在就加入 ioioTIMES 臉書粉絲團 更多互動、更多好康攏抵加!!
我們有LINE TODAY頻道了,快來追踪我們吧!!--最新科技新聞 盡在你手