MLPerf Inference v6.1的結果展示了軟體最佳化如何透過擴大模型覆蓋範圍和增加生態系統參與度來提升AI推理效能
在 MLCommons 最新發布的 MLPerf Inference v6.1 基準測試結果中,英特爾重點介紹了透過軟體最佳化,在英特爾 Xeon 6 處理器和英特爾 Arc Pro B 系列 GPU 上實現的 AI 推理效能提升。測試結果也反映出越來越多的客戶和合作夥伴參與其中,更多系統在更多模型、工作負載和部署場景下驗證了英特爾平台的效能。
在與 MLPerf v6.0 相同的晶片和插槽數量下,英特爾® Xeon® 6980P 處理器在 Llama 3.1 8B 伺服器吞吐量方面提升了 2.4 倍,離線吞吐量提升了 56% 1。這些提升僅透過軟體改進就得以實現,顯示持續最佳化能夠顯著提升客戶已部署硬體的效能。英特爾合作夥伴也展現了類似的成長動能。
"「MLPerf Inference v6.1 展示了持續的軟體最佳化如何能夠從客戶已部署的硬體中釋放出顯著的性能提升。在 Xeon 和 Arc Pro 平台上,我們將繼續增強完整的 AI 軟體堆疊,同時擴展我們的平台能夠支援的模型、工作負載和系統範圍。」" 英特爾資料中心集團資料中心軟體副總裁 Bill Pearson。
重要性:隨著人工智慧推理技術逐步投入生產,客戶需要能夠支援更大規模、更多樣化模型的平台,同時也要不斷提升效能、靈活性和價值。英特爾 MLPerf Inference v6.1 的結果證明,軟體最佳化可以擴展已部署基礎架構的有效性能,幫助客戶充分利用現有系統,並實現跨 CPU 和 GPU 運算的擴展。
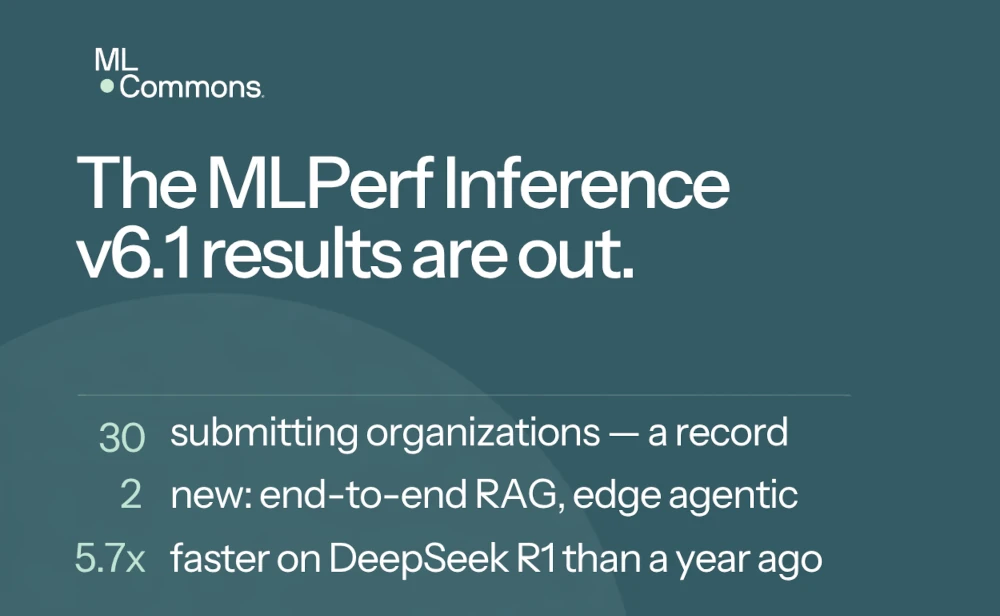
客戶和合作夥伴在英特爾平台上的參與度也從 v6.0 的 29 個結果增加到 v6.1 的 39 個結果,第三方驗證的範圍擴大到英特爾自身提交的結果之外2。 Oracle 首次提交了基於英特爾平台的驗證結果;Red Hat 首次提交了基於 Xeon CPU 的推斷結果;廣達雲端技術和 Supermicro 則首次提交了使用英特爾 Arc Pro B70 的合作夥伴驗證結果。
關於英特爾 Xeon 6 的結果:英特爾擴大了其在 MLPerf v6.1 中的 Xeon 參與範圍,從 v6.0 中的兩個基準測試 Xeon 6 SKU 增加到五個,CPU 推理結果的數量也從 24 個增加到 35 個。英特爾 Xeon 仍然是 MLPerf 推理提交中唯一有代表的獨立伺服器 CPU。
關於英特爾 Arc Pro B70 的結果: Intel Arc Pro B70 的測試結果進一步展示了軟體改進如何提升一系列 AI 模型的效能。單一節點配置四顆英特爾 Arc Pro B70 GPU,可提供 128GB 顯存,並支援 Llama 3.1 8B、Llama 2 70B、gpt-oss-120B、Whisper 以及端對端檢索增強產生 (E2E-RAG) 等模型。在與 v6.0 版本相同的四 GPU 系統上,gpt-oss-120B 伺服器效能提升了 36%,離線效能提升了 27%,這體現了英特爾軟體堆疊的持續成熟3。
關於全新 E2E-RAG 基準測試:英特爾也參與開發並提交了全新 MLPerf Inference v6.1 端對端檢索增強生成基準測試的結果,這是本輪測試中最複雜的新工作負載之一。此基準測試在一個由英特爾 Xeon 6787P 處理器和四塊英特爾 Arc Pro B70 GPU 組成的系統上進行,在單次運行中,工作負載被分配到 CPU 和 GPU 上,分別處理 AI 流水線的不同階段:Xeon 處理器負責嵌入、重排序、向量搜尋和小語言模型 (SLM) Arc AI 流水線的不同階段:Xeon 處理器負責嵌入、重排序、向量搜尋和小語言模型 (SLM) 大語言模型 (SLM) 的產生,而數據排序模型。測試結果展示了最佳化的 CPU 和 GPU 運算能力如何在完整的 AI 工作流程中協同工作。
英特爾的持續最佳化工作不僅限於基準測試結果。Xeon 處理器的改進被整合到廣泛使用的 AI 框架中,使客戶能夠在已部署的基礎設施上受益於軟體的進步;同時,針對英特爾 Arc Pro B70 的最佳化工作也有助於提升未來英特爾 GPU 產品的核心、框架和服務堆疊。
更多背景資訊: MLPerf 推理 v6.1 結果
1. 基於英特爾提交的 MLPerf Inference v6.1(ID:mint-lark-1a28)和 MLPerf Inference v6.0(ID:6.0-0057)的結果。配置:單節點,2 個英特爾® 至強® 6980P 處理器(128 核心),24 個 96GB DDR5 MRDIMM 8800 MT/s 記憶體(總計 2304GB),無獨立加速器。伺服器場景:1,139.51 對比 471.54 令牌/秒(2.4 倍)。離線場景:1,916.74 對比 1,229.56 令牌/秒(1.56 倍)。結果可能未反映所有公開更新。 MLPerf 名稱和標誌是 MLCommons 的商標。更多資訊請造訪 mlcommons.org。
2. 基於 mlcommons.org 上發布的 MLPerf 推理 v6.1 和 v6.0 封閉式分組結果。 「Intel 平台」定義為使用 Intel® Xeon® 處理器作為主要運算(僅 CPU 推理)或 Intel® Arc™ Pro GPU 作為加速器的提交。合作夥伴/客戶數量不包括 Intel 本身的提交。 MLPerf 名稱和標誌是 MLCommons 的商標。更多資訊請造訪 mlcommons.org。
3. 基於英特爾提交的 MLPerf Inference v6.1 和 MLPerf Inference v6.0(ID:6.0-0101)封閉式劃分測試結果。配置:單節點,1 個英特爾® 至強® 698X 處理器(86 核心),4 個英特爾® Arc™ Pro B70 GPU(每個 32GB GDDR6,PCIe Gen5 x16),8 個 16GB DDR5 6400 MT/s 記憶體(總計 128GB)。 gpt-oss-120B 伺服器端:1,296.87 對比 951.67 個 token/s(提升 36%)。 gpt-oss-120B 離線端:1,956.40 對比 1,536.90 個 token/s(提升 27%)。軟體:Ubuntu 24.04 上的 PyTorch vLLM。結果可能未反映所有公開可用的更新。 MLPerf 名稱和標誌是 MLCommons 的商標。請造訪 mlcommons.org 以了解更多資訊。
中秋節好康活動火熱響應-「中秋團圓、電腦也團圓」快來留言拿大獎!!
9月搞畏獎開跑中,搞畏有獎放送中
現在就加入 ioioTIMES 臉書粉絲團 更多互動、更多好康攏抵加!!
我們有LINE TODAY頻道了,快來追踪我們吧!!--最新科技新聞 盡在你手