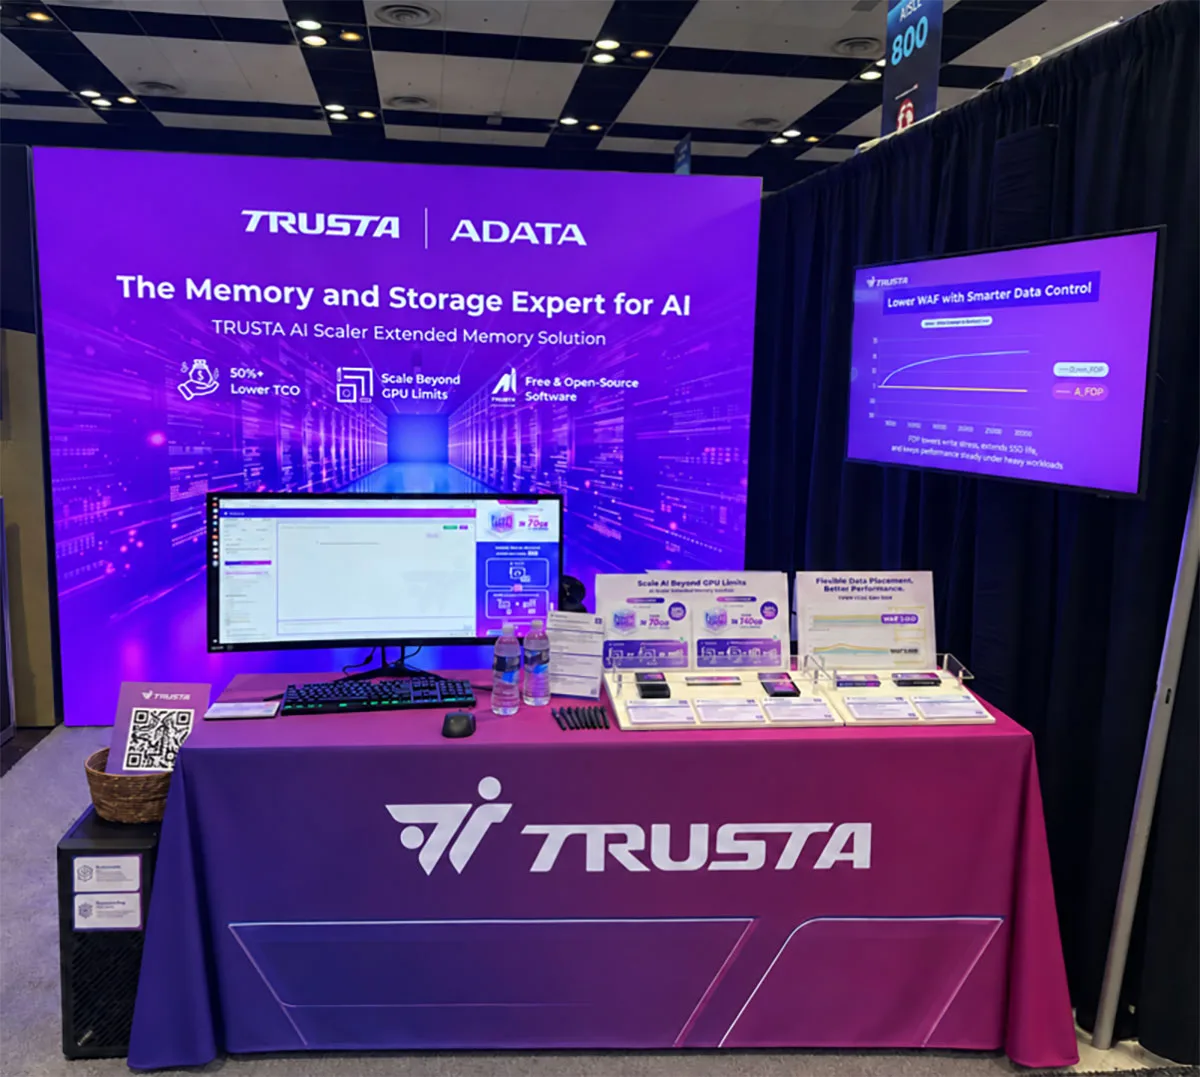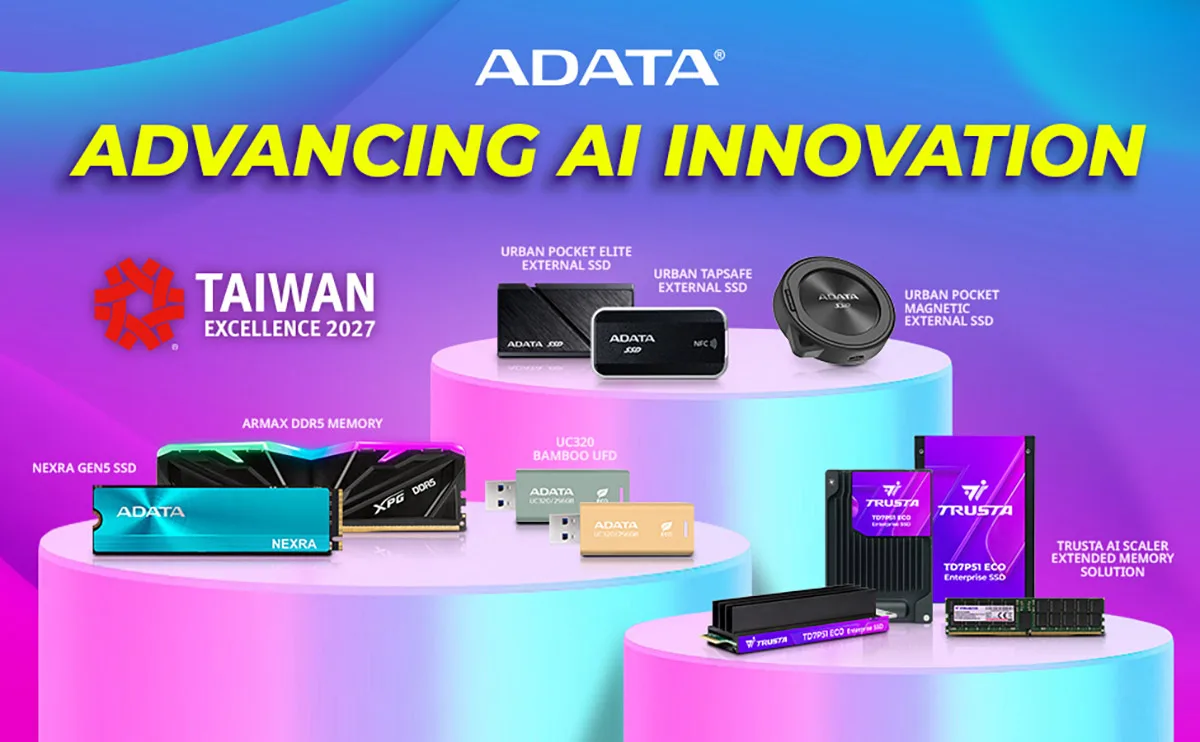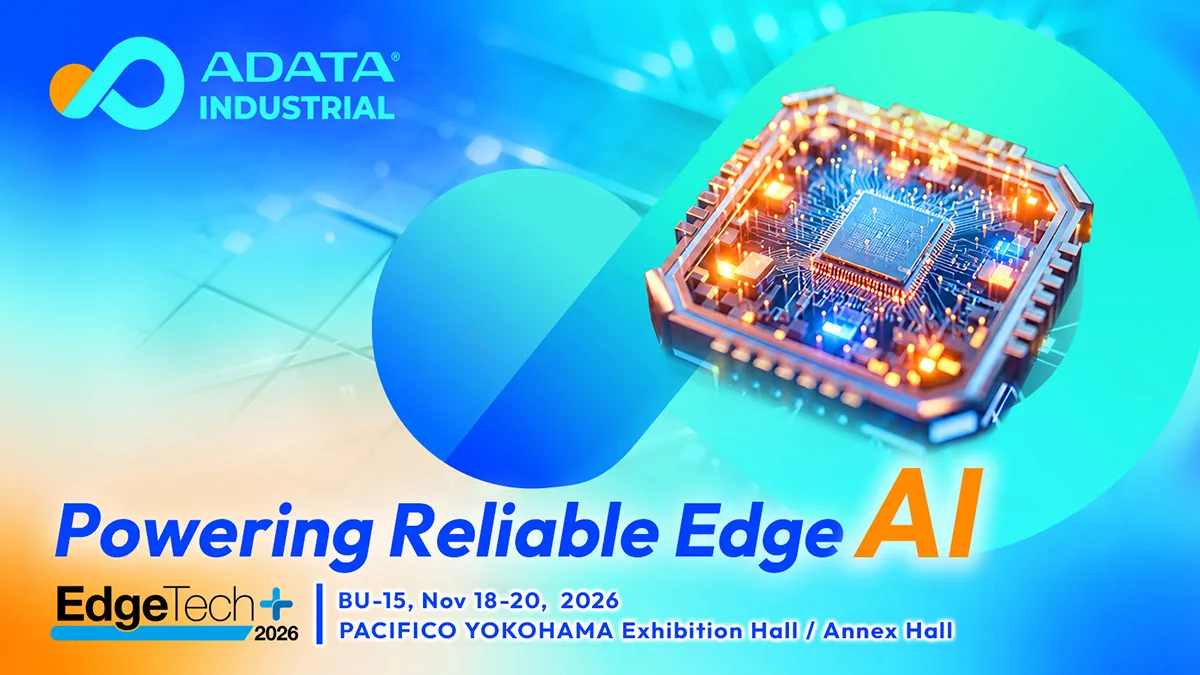
記憶體領導品牌威剛科技(ADATA)旗下企業級儲存品牌 TRUSTA,今日首度參與全球高效能運算與超級運算指標旗艦盛會 SuperComputing 2026(SC26)。本屆 SC26 預計吸引超過450 家參展商與逾 18,000 名參觀者,聚焦 AI 與高效能運算基礎架構的最新發展。TRUSTA 持續以 Scaling AI
Efficiently 為主軸,展示整合軟體、記憶體與儲存技術的 AI 解決方案。本次展出亮點包括最新升級的 AI ScalerToolkit 軟體方案,運用 vLLM 的 KV cache 卸載技術,將 AI 的工作記憶從 GPU 延伸至 DRAM 與 TRUSTA 企業級 SSD;長篇內容可直接從 SSD 讀回、無須重新運算,大幅縮短回應等待時間,協助企業在有限的 GPU 資源下,以更低成本於自家機房部署 AI。此外,AI Scaler Toolkit 亦整合 Strata 推論引擎,搭配 Intel AMX 加速技術,Prefill 提示詞預處理速度最高可提升 25%。
升級 AI Scaler Toolkit 整合 vLLM KV cache 卸載至 SSD 加速企業 AI 推論
AI 應用正從模型訓練走向推論,帶動儲存需求快速成長;根據 Counterpoint Research 統計,2026 年第二季企業級 SSD 已占全球 NAND 快閃記憶體容量出貨量的 48%,較去年同期的 26% 接近翻倍。大型語言模型(LLM)在推論時,會將讀過的內容保存在 KV cache 中;長篇文件、多輪對話與 AI Agent 應用,很快就會讓 KV cache 超出 GPU 記憶體容量。一旦 KV cache 被移出 GPU,就必須重新運算整段內容,使用者只能等待。全新升級的 AI Scaler Toolkit 整合企業廣泛採用的開源推論引擎 vLLM,並將 KV cache 分層存放:GPU 記憶體處理當下請求、DRAM 作為高速快取、TRUSTA PCIe Gen5 企業級 SSD 則提供大容量、低成本且重新啟動後仍能保存的儲存層。TRUSTA 實測顯示:
●長篇內容大幅加速:長篇文件可直接從 SSD 讀回,無須重新運算,大幅縮短 AI 回應前的等待時間。
● 重新開機後對話仍可接續:伺服器重新啟動或重新開機後,可直接從 SSD 讀回先前保存的 KV cache 接續對話,無須從頭重新運算。
AI Scaler Toolkit 亦提供一站式 AI 部署與管理體驗:一鍵安裝、支援多種 AI 模型與推論引擎(vLLM、llama.cpp與 Strata),並可於單一介面完成 GPU、DRAM 與 SSD 資源配置、參數調整與模型測試,降低企業導入地端AI 的操作門檻。
Strata 結合 Intel AMX 加速技術 提示詞預處理速度最高提升約 25%
針對需在有限 GPU 記憶體中運行超大型模型、並高效運用 DRAM 與 SSD 的特定部署情境,AI Scaler Toolkit亦整合輕量推論引擎 Strata。在 Intel Xeon 處理器上,Intel AMX 讓 CPU 直接處理存放於 DRAM 內的模型資料,提示詞預處理(Prefill)速度最高可提升約 25%*。
高效能企業級 SSD 與 DDR5 R-DIMM 強化 AI 運算基礎架構
除了 AI Scaler Toolkit 的軟體技術展示,TRUSTA 亦展出 PCIe Gen5 企業級 SSD 與 DDR5 R-DIMM,以高效能、高容量及高能效的記憶體與儲存產品,滿足 AI 伺服器與高效能運算環境的多元需求。
● TD7P51 ECO / T7P5 PCIe Gen5 企業級 SSD: 提供最高 15.36TB 容量,支援 U.2、E1.S 與 E3.S 等主流外觀規格,並具備最高3 DWPD 耐用度。透過 FDP 彈性資料放置技術(Flexible Data
Placement),提升儲存效率並延長使用壽命;同時具備低於 20W 的低功耗設計,能源效率優於同級產品 1.7 倍,協助資料中心降低用電,呼應全球綠色機房趨勢。
● 企業級 DDR5 R-DIMM: 提供最高 6,400 MT/s 傳輸速率與單條最高 128GB 容量,內建 ECC 錯誤修正技術,可自動偵測並修正資料錯誤,確保 AI 伺服器長時間高負載運作時依然穩定可靠。
TRUSTA 表示:「隨著企業 AI 應用持續發展,如何有效整合運算、記憶體與儲存資源,已成為提升 AI 部署效率與控制成本的關鍵。企業導入 AI 不必一味增購昂貴的 GPU,善用 CPU、記憶體與 SSD,同樣能讓 AI 跑得更快、更省。TRUSTA 這次透過全新升級的 AI Scaler Toolkit、企業級 SSD 與記憶體技術,協助企業善用既有硬體資源,打造更具彈性、效率與擴充性的 AI 運算環境,穩健且高效地擴展 AI 應用。」
*測試說明:數據為 TRUSTA 於 2026 年 11 月實測結果,比較 AI Scaler Toolkit 內建、啟用 Intel AMX 的TRUSTA 版 Strata 與原版 Strata v0.2.11。測試平台為 Intel Xeon w5-3535X 處理器搭配單張 NVIDIA RTX 6000 Ada GPU,使用混合專家(MoE)架構大型語言模型,僅量測 Prefill 階段,每項測試至少執行三輪並取中位數。單次輸入約 8K tokens 時速度提升約 11%;多輪對話中,每輪新增約 4K tokens 時提升約 25%;單次輸入超過約 12K tokens 時則無明顯差異。實際效能依硬體配置、模型與輸入長度而異。
【展覽資訊】
● 展會名稱: Supercomputing 2026 (SC26)
● 展出日期: 2026 年 11 月 17 日至 19 日
● 展出地點: 美國芝加哥 McCormick Place West – Exhibit Halls
● TRUSTA 攤位: #7214
11月搞畏獎現正開跑,留言抽好禮!!
ioioTIMES IG | Threads 歡迎加入!!
我們有LINE TODAY頻道了,快來追踪我們吧!!--最新科技新聞 盡在你手