Nemotron 3.5 Super VL速度提升5倍更加精準且可定制,擴展了NVIDIA面向始終在線代理的開放模型
而Nemotron 3.5 Bolt則將代理智能引入本地NVIDIA系統
NVIDIA 今天發布了 Nemotron 3.5 Super VL,這是一款開放的 1200 億參數模型,可為專業的常駐代理提供最快的任務完成速度和最高的準確度。
此外,還有兩款新的邊緣運算型號:Nemotron 3.5 Bolt 74B-A9B 24GB,針對本地代理工作負載進行了優化,以平衡每 GB 的智能和速度;以及 Nemotron 3.5 Bolt E4B 4GB,針對快速對話代理進行了優化,以每 GB 的智能優化。
Super VL 和 Bolt 74B-A9B 現已上市,Bolt E4B 將於 10 月 23 日上市。這三款開放式型號共同涵蓋了代理部署的各個方面,從大型企業伺服器到邊緣設備和本地硬體。
現在,任何想要在 NVIDIA 基礎架構上執行代理程式的組織都可以擁有一個開放的、最佳化的層級模型,而無需在功能和可部署性之間做出選擇。
Super VL 和 Bolt 加入了 Nemotron 家族,與 Lightning 和 Ultra 一起。
Lightning 於 8 月發布,可處理高吞吐量工作負載;Ultra 可處理最困難的推理任務;而 Bolt 則將智慧帶到了邊緣。
Nemotron 3.5 Super VL:精準度領先業界,體積卻只有五分之一
Super VL 與Nemotron 聯盟合作開發,在多模態智能體任務(指令遵循、工具使用、多步驟業務工作流程和視覺理解)方面具有領先的準確性,其性能可與 NVIDIA 最大的推理模型相媲美,而參數數量卻只有後者的五分之一左右。
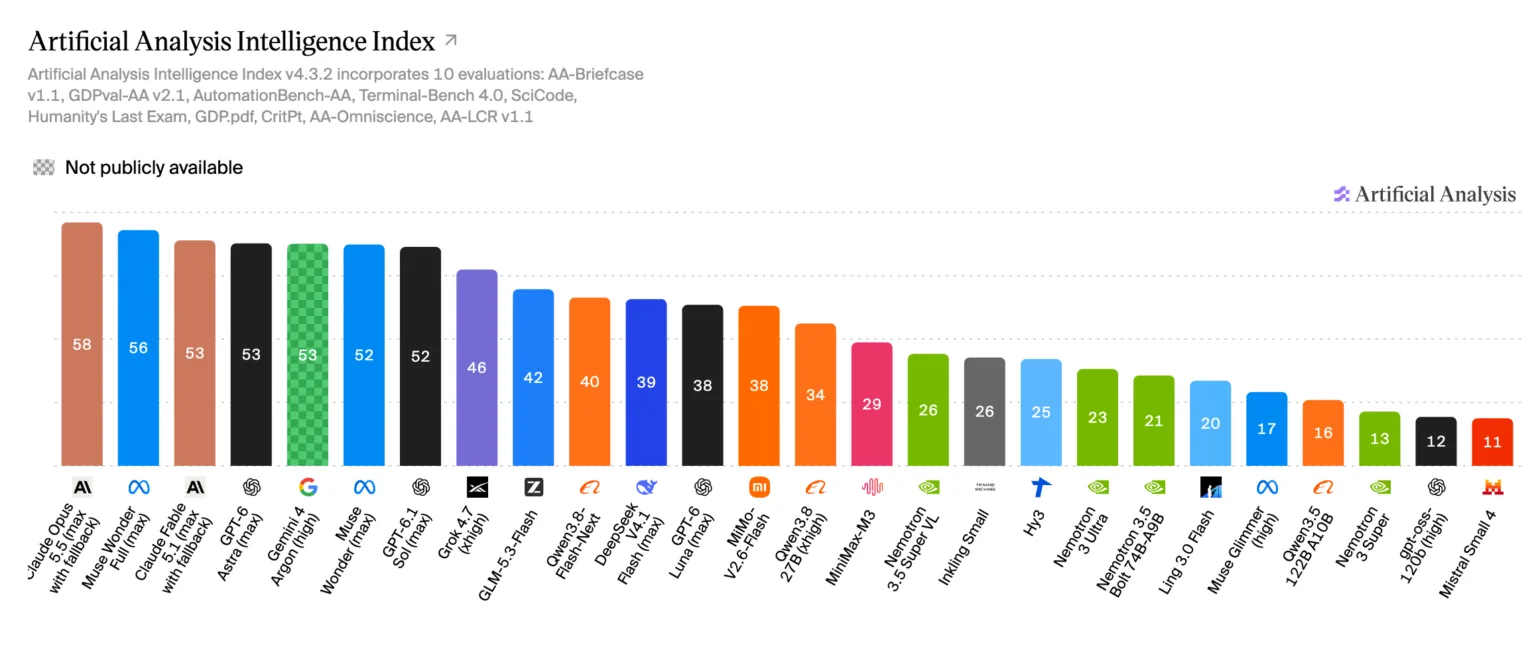
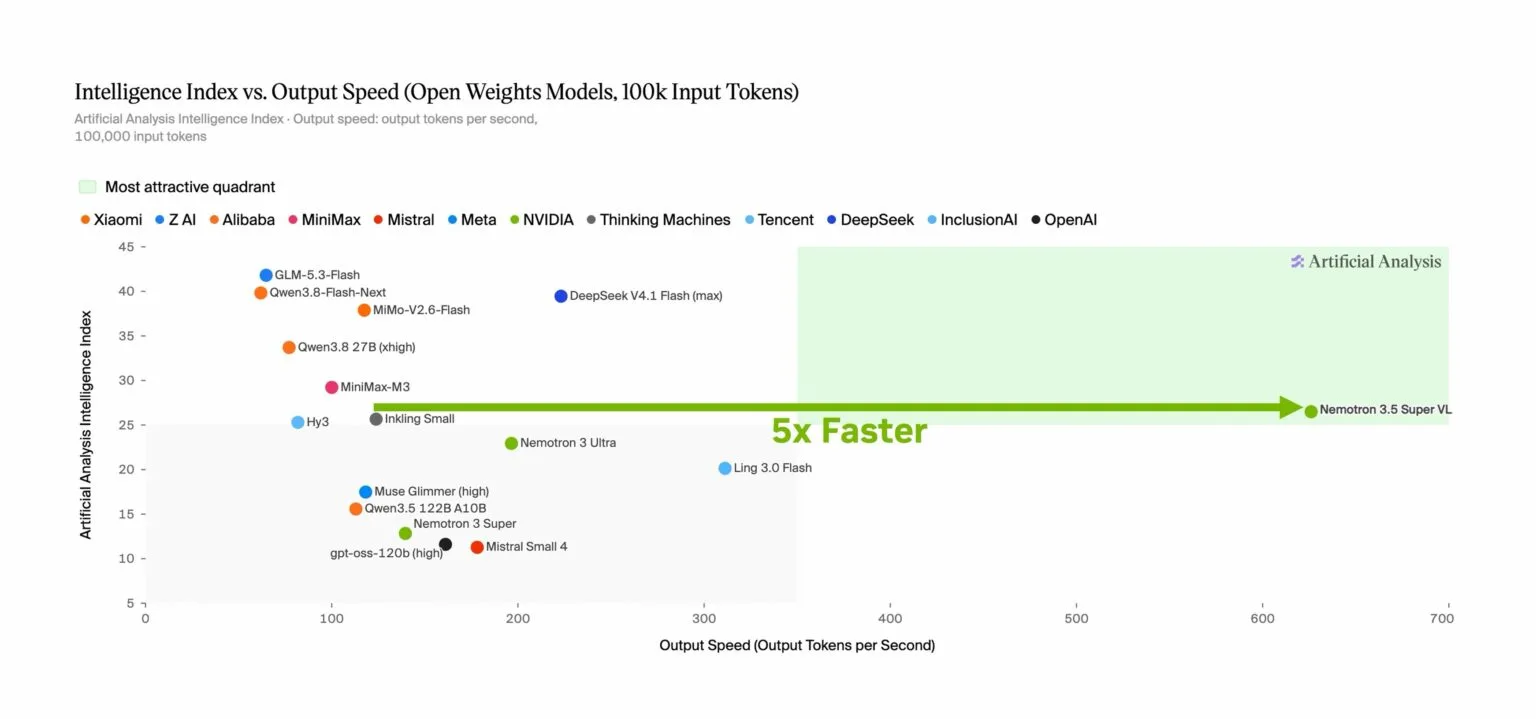
作為同類產品中最快的開放式代理模型(比第二快的模型快 5 倍),它可以幫助企業代理更快地完成跨越數天或數週的大量工作流程任務。
與封閉邊界模型不同,組織可以使用自己的資料對 Super VL 進行後訓練,將其部署在自己的基礎設施上,並監督他們所建置的內容。
Nemotron 3.5 Bolt:邊緣智能
Bolt 74B-A9B 24GB 專為在 NVIDIA RTX/DGX Spark 上本地運行日常代理任務而設計,採用原生 2 位元量化技術,可容納 24GB 記憶體並與其他應用程式一起運行。
與其他內存佔用量相近的型號相比,它在智能性和速度之間取得了良好的平衡:既足夠智能以完成大多數任務,又比最智能的型號快得多。
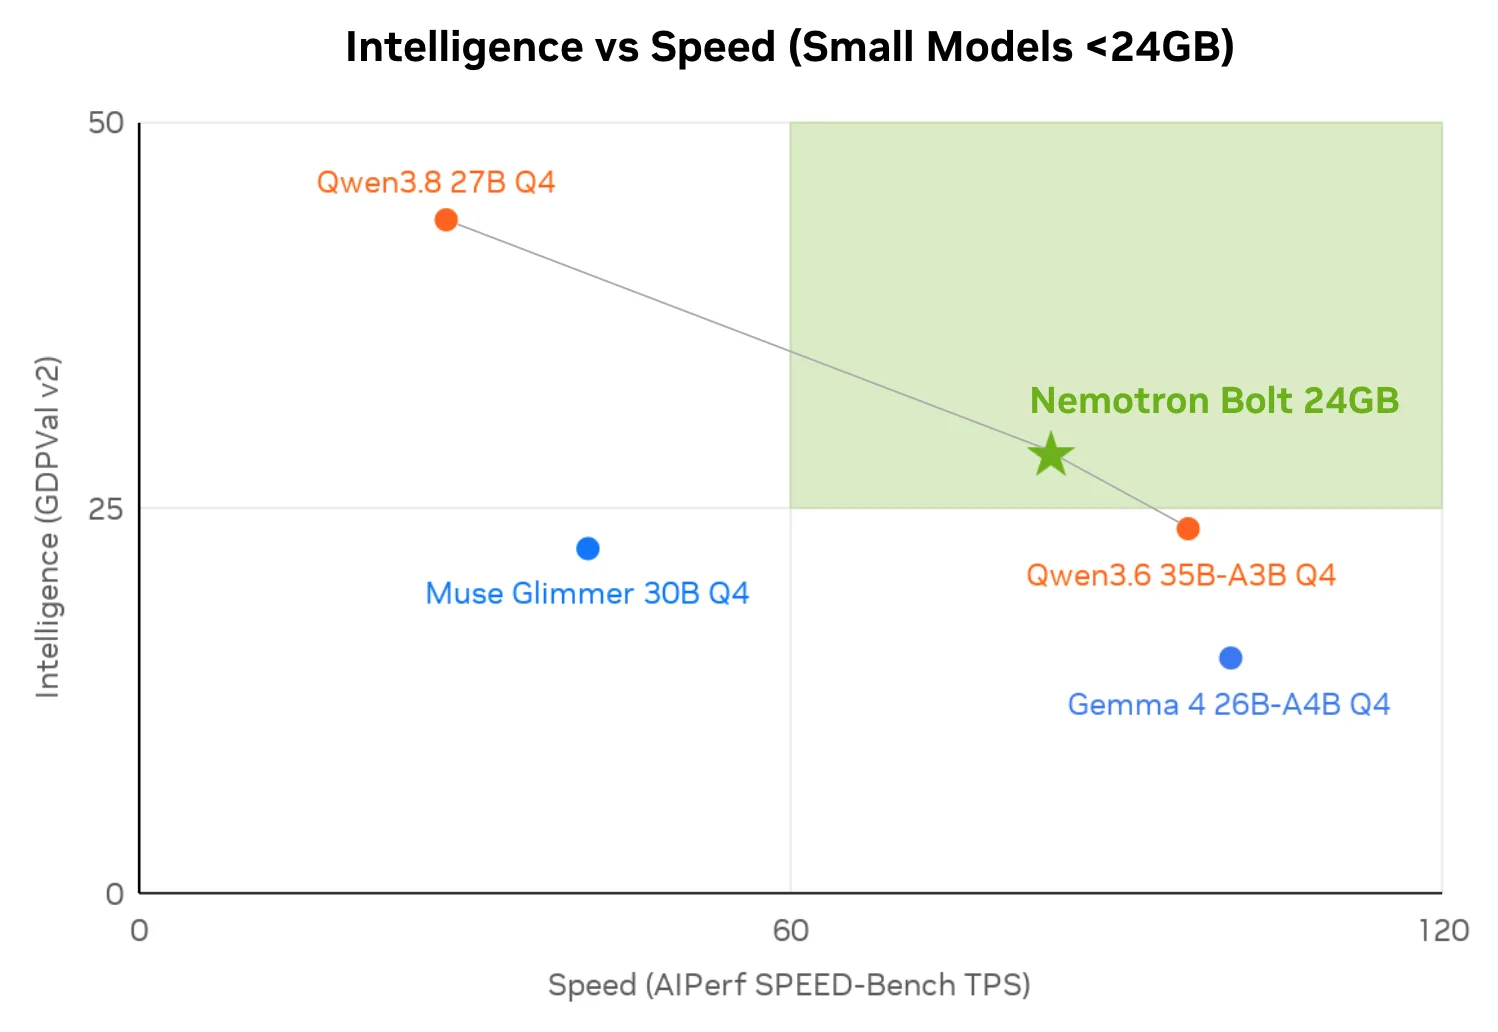
借助 Bolt 74B-A9B 24GB,使用者可以將專案委託給常用的本機代理框架——從網路搜尋到程式碼編寫和除錯——所有這些都無需將這些工作負載傳送到雲端。它在 PinchBench 同類產品中排名第一,在 BrowseComp 排名第二。 Bolt E4B 4GB 專為 GeForce RTX、Jetson 和 RTX/DGX Spark 上的實體和對話代理而設計。它將自然對話與多輪代理功能相結合,為快速的本地語音助理、互動式角色和嵌入式介面提供支援。
採用客製化超級智能
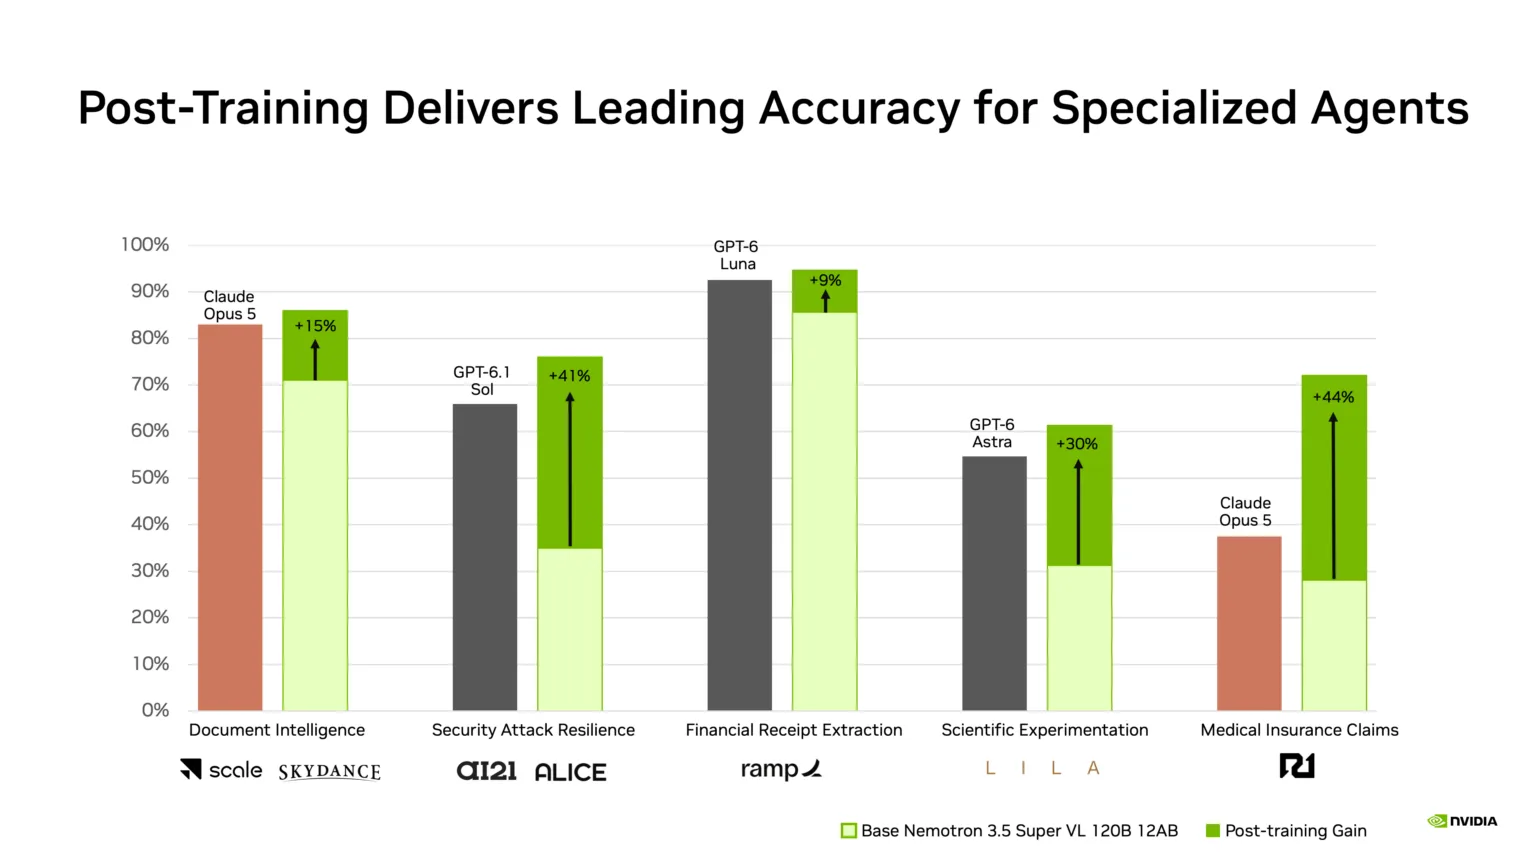
數十家不同行業的組織正在利用自身的資料、工具、策略和工作流程對 Super VL 進行後訓練,以提高其代理部署中特定任務的準確性。
Super VL 已被各行各業的組織進行後訓練和客製化。 Scale AI 為 Skydance 的供應商信貸融資代理商和 EY 的併購盡職調查代理商進行了模型後訓練。 AfterQuery 為 Hebbia 客製了模型,用於信貸協議分析。 AI21 和 Alice 為網路安全攻擊恢復能力進行了模型後訓練。 Mercor 在 APEX -SWE 編碼基準測試上對模型進行了後訓練,該基準測試適用於規劃、編寫和調試程式碼的編碼代理。 ModelScope 使開發人員能夠透過其 ms-swift 框架對模型進行微調,以用於特定的多模態應用程式。
其他客製化 Nemotron 3.5 Super VL 的機構包括:Ramp (提供財務文件智慧服務)、Dream (提供基於人工智慧的獨立網路安全研究和漏洞分析服務)、Lila Sciences (提供科學發現和搜尋服務)以及 R1 (提供醫療索賠分析和收入週期管理服務)。 TrainLoop 使用 Nolla 的皮膚病學資料對模型進行了後訓練,Nolla 剛剛成為第一個獲準使用人工智慧開立初始患者處方的公司。整合 Nemotron 3.5 Super VL 的軟體平台公司包括:
- Atlassian ,用於執行諸如跨 Jira 和 Confluence 等應用程式的代理搜尋等任務。
- CrowdStrike 正在為企業安全領域的代理藍隊測試客製化模型。
- 達梭系統,為工程設計和模擬提供動力。
- Perplexity ,用於 Perplexity Search and Computer 中的搜尋和代理任務。
- Salesforce 正在透過 Missionforce Operations 對 Nemotron 進行客製化,以支援 AI 代理在安全的客戶環境中實現複雜政府工作流程的數位化和自動化。
- Synopsys 半導體設計驗證軟體可與此模型進行互通。
Nemotron 3.5 Super VL實際觀測到的景象
Nemotron 3.5 Super VL 的視覺語言優勢針對的是代理在實踐中遇到的情況:光學字元辨識、表格、圖表和視覺文件中的結構化資訊。
它處理網頁,提取文本,讀取圖表,並根據發現的內容返回分析結果。這同樣適用於 PDF 和其他代理商常用的文件。
Nemotron 3.5 Super VL 能夠理解圖像、網頁和 PDF 文件,並根據理解結果採取行動。將文字和視覺理解融合在一個模型中,意味著智能體無需在不同的系統之間路由任務——上下文資訊貫穿始終,確保工作從文件到資料再到決策的整個過程。
開放以實現最大程度的控制、安全和隱私
開放性和可自訂性相輔相成。此模型附帶開放權重、開放資料集和訓練方案。
控制權是雙向的。組織可以根據自身的安全性和資料駐留要求,在任何需要的地方運行該模型。他們還可以選擇採用可自行調整的模型,而不是受制於服務提供者限制的模型。
例如,在保險業,客製化的代理程式可以重複掃描理賠記錄,識別詐欺跡象。在金融服務業,代理程式可以審查信用評分,並根據機構本身的貸款標準標記異常活動。此模型部署在企業內部,資料也嚴格保密。
NVIDIA NeMo、基於 Python 的管道和開放資料集支援自訂。
Nemotron 3.5 Super VL 在預訓練和持續預訓練中使用了約 26 兆個 token 進行訓練,然後在數十個環境中使用約 380 萬個樣本進行後訓練和強化學習。
NVIDIA 也發布了關於 Hugging Face 的開放資料集,涵蓋了智慧工具的使用、金融、指示遵循、長上下文、公平性和視覺語言理解,以及 NeMo Gym 中的強化學習環境。
NVIDIA NIM 將該模型打包為生產就緒的微服務,具有性能優化、經過驗證的配置和企業級支持,每兩週更新一次安全性修補程式和性能改進。
透過 NVIDIA Dynamo 運行的模型,企業可以為多達 8 倍的用戶提供服務,同時延遲降低 85%。
Nemotron 3.5 Super VL 現已在 Hugging Face、Open Router、ModelScope 社群和 NVIDIA NIM 上提供。
可在DGX Spark、DGX Station和RTX上運行
Nemotron 3.5 Super VL 可在 NVIDIA 的整個硬體堆疊上運行:在DGX Spark、DGX Station、RTX PRO 和 RTX 系統上實現桌面本地智能,在NVIDIA Jetson上實現邊緣智能,以及在資料中心和雲端環境中運行。
Nemotron 3.5 Bolt 74B-A9B 24G B 現已在 Hugging Face 上架,支援 llama.cpp、Ollama、LM Studio、Unsloth和vLLM。它專為10 月 16 日上市的 NVIDIA RTX Spark 筆記型電腦而設計,也可在 GeForce RTX PC、DGX Spark、DGX Station 和 RTX PRO 工作站上運行。
看QNAP活動文拿好禮
現在就加入 ioioTIMES 臉書粉絲團 更多互動、更多好康攏抵加!!
我們有LINE TODAY頻道了,快來追踪我們吧!!--最新科技新聞 盡在你手