採用NVIDIA Vera Rubin NVL72系統的首次預覽測試結果,其輸送量最高達NVIDIA GB300 NVL72的3.7倍
系統效能、高效的基礎設施擴展能力,以及持續的軟體最佳化,
這三者的基礎在於平台通用性。
NVIDIA 平台專為全面最佳化上述能力而打造,今日公布的 MLPerf Inference v6.1 結果便充分展現這點:
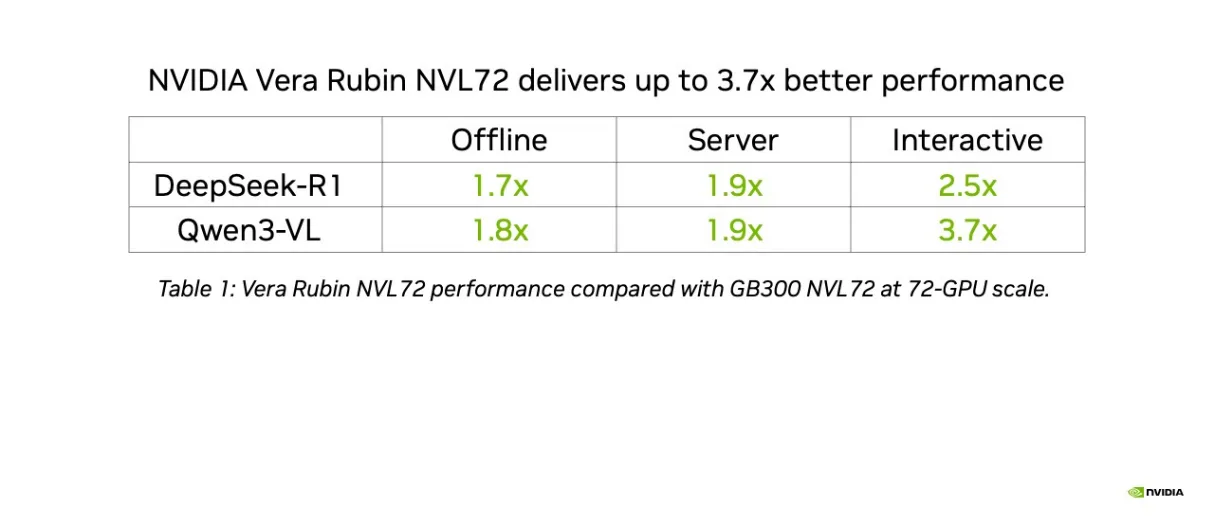
● NVIDIA Vera Rubin NVL72系統首度亮相即展現領先效能:在首次 MLPerf Inference 預覽測試結果中,NVIDIA Vera Rubin NVL72 的輸送量較 GB300 NVL72 提升高達 3.7 倍。
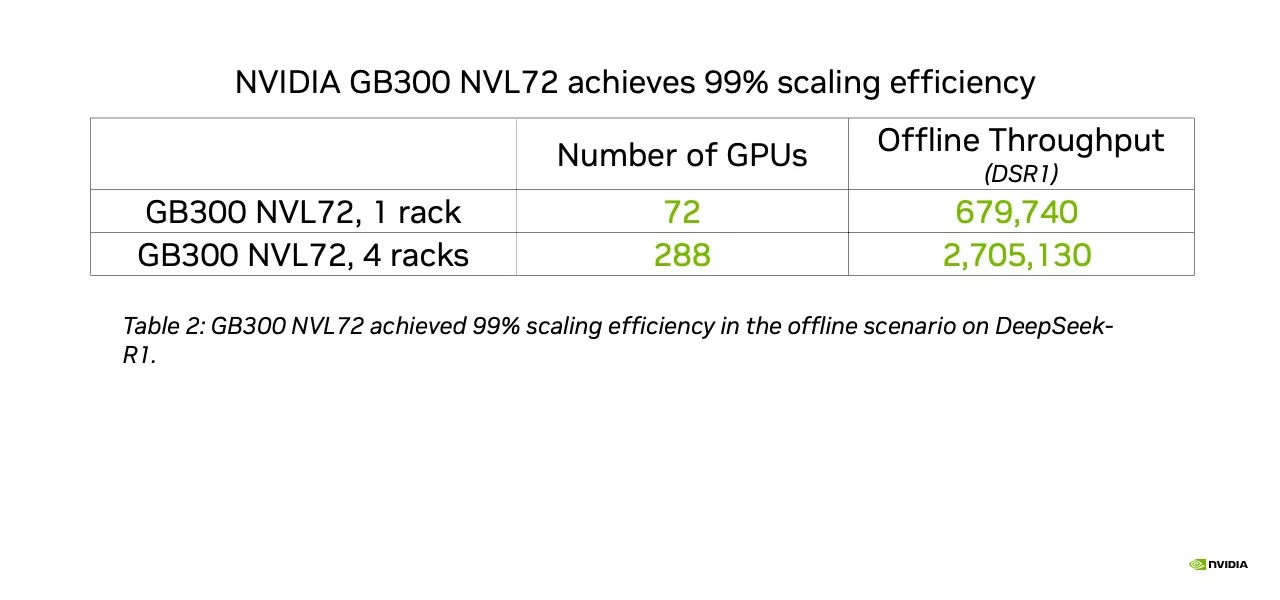
● NVIDIA GB300 NVL72展現領先的擴展效率:一項橫跨四座 GB300 NVL72 機架、共使用 288 顆GPU的測試配置,達成 99% 的擴展效率,其輸送量相較單一機架基準近乎呈現線性成長。
● 持續的軟體最佳化推動效能提升:NVIDIA 在 MLPerf Inference v6.1 提交結果中的軟體最佳化,相較於 v6.0 版本,效能最高提升 1.6 倍。v6.1 提交截止後,最佳化工作仍持續進行,進一步帶來效能提升。
對於正在評估 AI 基礎設施決策的組織而言,效能、擴展效率與軟體速度,
Vera Rubin NVL72首度亮相MLPerf Inference即展現領先效能
NVIDIA 針對 MLPerf Inference v6.1 測試套件中,兩項最具挑戰性的基準測試 DeepSeek-R1 與 Qwen3-VL,提交 Vera Rubin NVL72 的預覽測試結果。
在離線、伺服器及互動情境下,Vera Rubin NVL72 採用 vLLM 與 NVIDIA Dynamo 開源推論框架,在 Qwen3-VL 上的輸送量最高達 GB300 NVL72 的 3.7 倍。在 DeepSeek-R1 上,採用 NVIDIA TensorRT-LLM 函式庫的輸送量則最高達 GB300 NVL72 的 2.5 倍。這些初步成果展現 NVIDIA 加速創新的步伐,以及效能如何透過持續的軟體最佳化進一步提升。
這項效能代表每座 Vera Rubin NVL72 機架所產生的詞元數量、服務的使用者數量,以及創造的營收,
這些成果反映硬體與軟體的全端協同設計。Vera Rubin 增強的 Tensor Core 與 Transformer Engine 可加速推論的預填充與解碼階段,而 NVFP4 精度則能降低模型權重、注意力與 KV 快取的記憶體占用量,在幾乎不犧牲輸出品質的情況下提高輸送量。
Vera Rubin 提交結果大量採用分離式服務,將預填充與解碼分開處理,
NVL72 垂直擴展網域採用第六代 NVIDIA NVLink 與 NVLink Switch,相較現成乙太網路可提供高達 10 倍的封包速率,並將延遲降低 3 倍,建立互連基礎,讓這些技術能在機架規模下有效運作。
這項協同設計更延伸至 NVIDIA 合作夥伴生態系。Nebius 同樣提交 Vera Rubin NVL72 預覽測試結果,並展現出卓越的效能。
能夠進行多步驟推理、規劃與行動的 AI 代理,正在重塑推論效能的衡量方式。在 SemiAnalysis AgentX 等旨在反映這項轉變的基準測試中,Vera Rubin NVL72 於預覽測試的效能達 GB300 NVL72 的 30 倍。此外,即將推出的 MLPerf Endpoints 基準測試將為代理型推論工作負載帶來標準化的衡量方式,
NVIDIA GB300 NVL72展現領先的擴展效率
擴展效率是衡量新增 GPU 能如何有效轉化為輸送量成長的指標,也是評估 AI 基礎設施生產力的關鍵標準。NVIDIA 透過各機架內具備高頻寬與低延遲的垂直擴展互連、
NVIDIA 的 DeepSeek-R1(DSR1)提交結果從單座 GB300 NVL72 機架的 72 顆 GPU,擴展至四座機架的 288 顆 GPU,並在離線情境中達到 99% 的擴展效率。輸送量幾乎與增加的硬體數量成比例成長。
擴展效率至關重要,因為增加 GPU 並不會自動帶來成比例的輸送量成長。如果 GPU 數量增加近一倍,輸送量卻僅提升個位數百分比,
GB300 NVL72 亦在 WAN 2.2 文字轉影片基準測試中展現機架規模效率,達到每秒生成 0.65 部 720p 影片,每部影片生成時間為 5.7 秒,輸送量達單一節點的 9 倍,延遲則降低 7.5 倍。
軟體最佳化持續推動效能提升
平台持續進行軟體開發,不斷提升效能並增加新功能。NVIDIA 在 v6.1 中,GB300 NVL72 於 Qwen3-VL 的效能最高達 v6.0 結果的 1.6 倍。這些提升來自較低精度的 KV 快取、更多核心融合、效能更高的核心,以及採用 vLLM 與 NVIDIA Dynamo 的分離式服務。
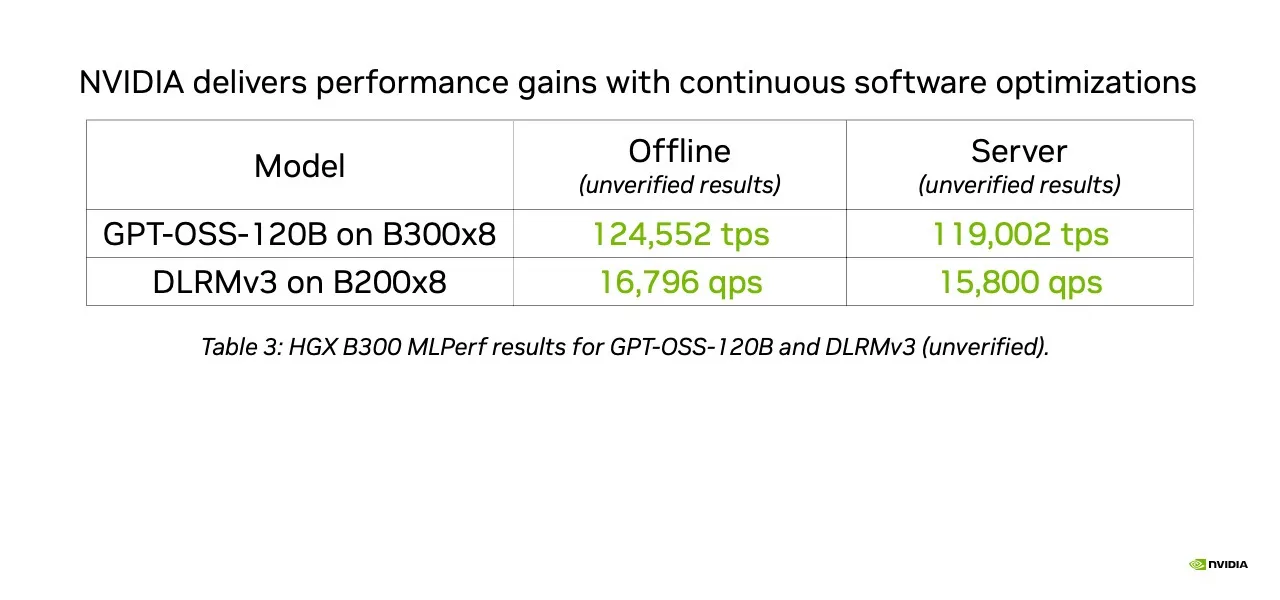
軟體最佳化工作在 v6.1 提交截止後仍持續進行。針對 GPT-OSS-120B 與 DLRMv3 的提交後測試結果尚未經 MLCommons 驗證,但已顯示進一步的效能提升。
各種規模的AI推論
除了 NVIDIA Grace Blackwell 與 Vera Rubin NVL72 平台的結果外,NVIDIA 亦在全新推出的 Edge-Agentic 基準測試中,提交 Jetson AGX Thor 採用 NVIDIA TensorRT Edge-LLM 執行 Qwen3.6-27B 的結果。
NVIDIA 合作夥伴生態系廣泛參與此次測試,共有 19 家合作夥伴展現出色效能,其中 8 家更採用多節點 Blackwell NVL72 系統。參與夥伴包括華碩、Azure、思科、CoreWeave
從精巧的邊緣裝置到規模最大的 AI 工廠,NVIDIA 持續透過每年推出平台架構更新、不斷改善的軟體,
進一步瞭解 NVIDIA Vera Rubin 平台。
MLPerf Inference v6.1 封閉組別。結果於 2026 年 9 月 16 日擷取自 www.mlcommons.org。NVIDIA 平台結果來自以下提交項目:6.1-0073 與 6.1-0074。MLPerf 名稱與標誌為 MLCommons Association 在美國及其他國家的註冊與未註冊商標。保留所有權利。
9月搞畏獎開跑中,搞畏有獎放送中
現在就加入 ioioTIMES 臉書粉絲團 更多互動、更多好康攏抵加!!
我們有LINE TODAY頻道了,快來追踪我們吧!!--最新科技新聞 盡在你手